Bielik na NPU Arduino VENTUNO Q (z porównaniem do Snapdragona X Elite)
1. Arduino VENTUNO Q
Oprócz laptopa z nieużywanym NPU mam również Arduino VENTUNO Q: płytkę z układem Qualcomm Dragonwing IQ-8275, 16 GB RAM i NPU Hexagon. Czas przyjrzeć się również jej. W poprzednim eksperymencie na laptopie ze Snapdragonem X Elite sprawdzałem, do czego NPU w laptopie może się przydać. Teraz chcę zobaczyć, co daje na mniejszym urządzeniu: jak duży model da się uruchomić i czy odpowiedź będzie wystarczająco szybka.
Wybrałem Bielika, bo docelowo interesuje mnie praca po polsku, a ta rodzina modeli powstała właśnie z myślą o tym języku. Seria v3.0 pozwala też porównać kilka rozmiarów: 1.5B, 4.5B i 11B. Minitron 7B był dodatkowym kierunkiem prób, poza głównym porównaniem.
Świadomie wybieram v3.0, nie nowszą v3.1: v3.1 ma jeden rozmiar (11B), a nie wiedziałem nawet, czy tyle wejdzie na NPU płytki. v3.0 ma kilka wersji, więc łatwiej było wyznaczyć granicę.
Chciałem odpowiedzieć na trzy pytania:
- Jak duży Bielik daje się uruchomić i jak szybko odpowiada?
- Jak kwantyzacja wpływa na wyniki wybranych zadań po polsku?
- Jak przygotować własny model, gdy nie ma gotowego GGUF?
Najważniejsze wyniki: Na laptopie CPU było szybsze w generowaniu kolejnych tokenów, ale na płytce okazało się inaczej.
- Na VENTUNO Q Bielik 4.5B Q4_0 w trybie
npuosiągnął 11,5 tok/s, wobec 5,4 tok/s na CPU. Czas do pierwszego tokenu wyniósł około 0,46 s zamiast 4,53 s. - Na X Elite ten sam wariant 4.5B generował szybciej na CPU: 28,2 wobec 14,0 tok/s.
- Na NPU płytki nie udało się uruchomić 11B: Q4_0 i Q4_K_M nie przeszły ładowania w trybach
npuihybrid. CPU działało, jednak dawało tylko około 2,1-2,4 tok/s. - Q8_0 zmieniało wyniki wybranych polskich zadań nieznacznie. Wpływ Q4_0 był większy i zależał od zadania.
2. Który Bielik i czym różnią się wersje?
2.1. Rodzina modeli, a nie jeden plik
Bielik to rodzina modeli językowych rozwijana przez SpeakLeash we współpracy z ACK Cyfronet AGH. Modele uczą się m.in. na polskich danych, ale nie są ograniczone do języka polskiego. W tym eksperymencie użyłem wariantów v3.0-Instruct, czyli dostrojonych do wykonywania poleceń i rozmowy. Badane modele v3.0 są udostępnione na licencji Apache 2.0.
| Nazwa | Co oznacza w tym artykule |
|---|---|
| Bielik-1.5B-v3.0-Instruct | Najmniejszy z badanych modeli, około 1,6 mld parametrów |
| Bielik-4.5B-v3.0-Instruct | Większy model z serii Small, około 4,8 mld parametrów |
| Bielik-Minitron-7B-v3.0-Instruct | Skompresowany wariant 11B, około 7,4-7,5 mld parametrów - poza głównym benchmarkiem |
| Bielik-11B-v3.0-Instruct | Największy w tym porównaniu, około 11,2 mld parametrów |
Minitron to nie mocniejsza kwantyzacja 11B. Powstał przez przycinanie struktury sieci i destylację wiedzy: zmienia się sama sieć, a nie tylko precyzja zapisu jej liczb. Szczegóły opisuje raport Bielik-Minitron-7B.
Warianty Base są modelami bazowymi, przed dostrojeniem do wykonywania poleceń. Tutaj testuję Instruct. Nazwa rodziny nie zastępuje sprawdzenia wersji i licencji konkretnego modelu.
Dla uruchamiania ważne jest to, że użyte modele są obsługiwane przez llama.cpp.
11B ma 50 warstw i deklarowane okno 32 768 tokenów, a seria Small - okno 8192.
Small nie jest po prostu pomniejszoną kopią 11B: różni się budową i treningiem,
choć obie serie deklarują klasę LlamaForCausalLM. Nazwa llama w metadanych
nie oznacza, że pobrałem niezmienioną Llamę od Meta. Szczegóły opisują raporty
Bielika 11B v3 i
Bielika Small.
2.2. Czego tutaj nie testuję
- v3.1: oficjalna seria obejmuje tylko samodzielny model 11B. v3.0 pozwoliła mi porównać kilka rozmiarów. Nie przenoszę wyników v3.0 na nowszą wersję.
- DFlash: model pomocniczy do przyspieszania generowania przez speculative decoding, nie mały, samodzielny zamiennik 11B.
- FP8 i AWQ: inne sposoby przygotowania wag. Tutaj porównuję GGUF w Q4_0, Q8_0 i Q4_K_M, a nie wszystkie dostępne formaty.
- Bielik-PL-11B i PL-Minitron-7B: osobne warianty, poza wynikami tego artykułu.
3. Jak model trafia na NPU?
Model można uruchomić jako GGUF przez backend Hexagon albo przygotować przez narzędzia Qualcomma do wykonania w QNN. Z QNN może również korzystać ONNX Runtime przez QNN Execution Provider, który oficjalnie wspiera inferencję na Linux ARM64.
Tutaj testuję GGUF. Kompilacji Bielika do QNN, wykonywanej np. przez plugin
qairt, ani uruchomienia przez ONNX Runtime na VENTUNO Q jeszcze nie sprawdzałem.
Użyłem GenieX, narzędzia Qualcomma z różnymi
pluginami wykonawczymi. W tym artykule działa llama_cpp:
GGUF -> GenieX, plugin llama_cpp -> backend ggml-hexagon -> Hexagon NPUTo nie jest ścieżka skompilowanych grafów QNN. Do jej uruchomienia nie trzeba najpierw eksportować modelu do ONNX.
Dlaczego zacząłem od Q4_0? Tutorial Arduino wprost zaleca ten wariant na NPU: „For NPU execution, prefer a Q4_0 quantization”. Sprawdziłem też Q8_0 i Q4_K_M.
4. Jak i na czym testowałem
4.1. Sprzęt i pomiar szybkości
| Element | Laptop | Płytka |
|---|---|---|
| Urządzenie | Lenovo Yoga Slim 7x | Arduino VENTUNO Q |
| SoC | Snapdragon X Elite X1E-78-100 | Dragonwing IQ-8275 |
| Hexagon | HTP v73 | HTP v75 |
| RAM | 32 GB | 16 GB |
| System | Windows ARM64 | Ubuntu 24.04 ARM64 |
| GenieX | v0.10.0 | v0.9.3 |
Główne porównanie obejmuje 1.5B, 4.5B i 11B, kwantyzacje Q4_0, Q8_0 i Q4_K_M oraz
tryby cpu, npu i hybrid. Na płytce nie testowałem 11B Q8_0 z powodu napotkanych problemów, opisanych dalej.
Każda pełna seria zawiera próbę wprowadzającą i pięć prób mierzonych. Podaję medianę pięciu prób z ostatniej kompletnej serii danej konfiguracji. Nie mieszam ich z pojedynczymi próbami uruchomienia ani nie liczę mediany z median różnych sesji.
Ustawienia: okno 4096 tokenów, limit 128 nowych tokenów, seed 42 i --think=false.
Efektywna temperatura wynosiła 0,8: plugin zastępował przekazane 0 wartością domyślną.
TTFT to czas do pierwszego tokenu raportowany przez silnik, bez ładowania modelu. Prefill oznacza przetwarzanie pytania, a decode generowanie odpowiedzi.
We wszystkich próbach użyłem tego samego promptu:
Wyjaśnij po polsku, czym różnią się CPU, GPU i NPU podczas lokalnego uruchamiania dużych modeli językowych. Opisz kolejno przetwarzanie promptu, generowanie kolejnych tokenów, pamięć wag i pamięć roboczą oraz znaczenie opóźnienia pierwszego tokenu. Użyj kilku pełnych akapitów, podaj przykład asystenta głosowego i zakończ krótkim podsumowaniem. Nie skracaj odpowiedzi do listy haseł.
4.2. Jak sprawdzałem jakość
Porównałem F16/BF16, Q4_0 i Q8_0 na 5174 przykładach z pięciu zadań używanych
w Open PL LLM Leaderboard,
według definicji SpeakLeash.
Testy wyboru odpowiedzi uruchamiałem przez llama-server na RTX 4090 z CUDA
pod Linuksem, w wariancie 0-shot bez szablonu rozmowy. Nie jest to pomiar jakości
swobodnej rozmowy ani poprawności wykonania na NPU.
5. Wyniki
5.1. X Elite: CPU generuje szybciej, NPU wcześniej zaczyna
Porównałem 27 kombinacji tych trzech modeli, trzech kwantyzacji i trzech trybów. W tabeli podaję tempo generowania odpowiedzi (decode), w tok/s.
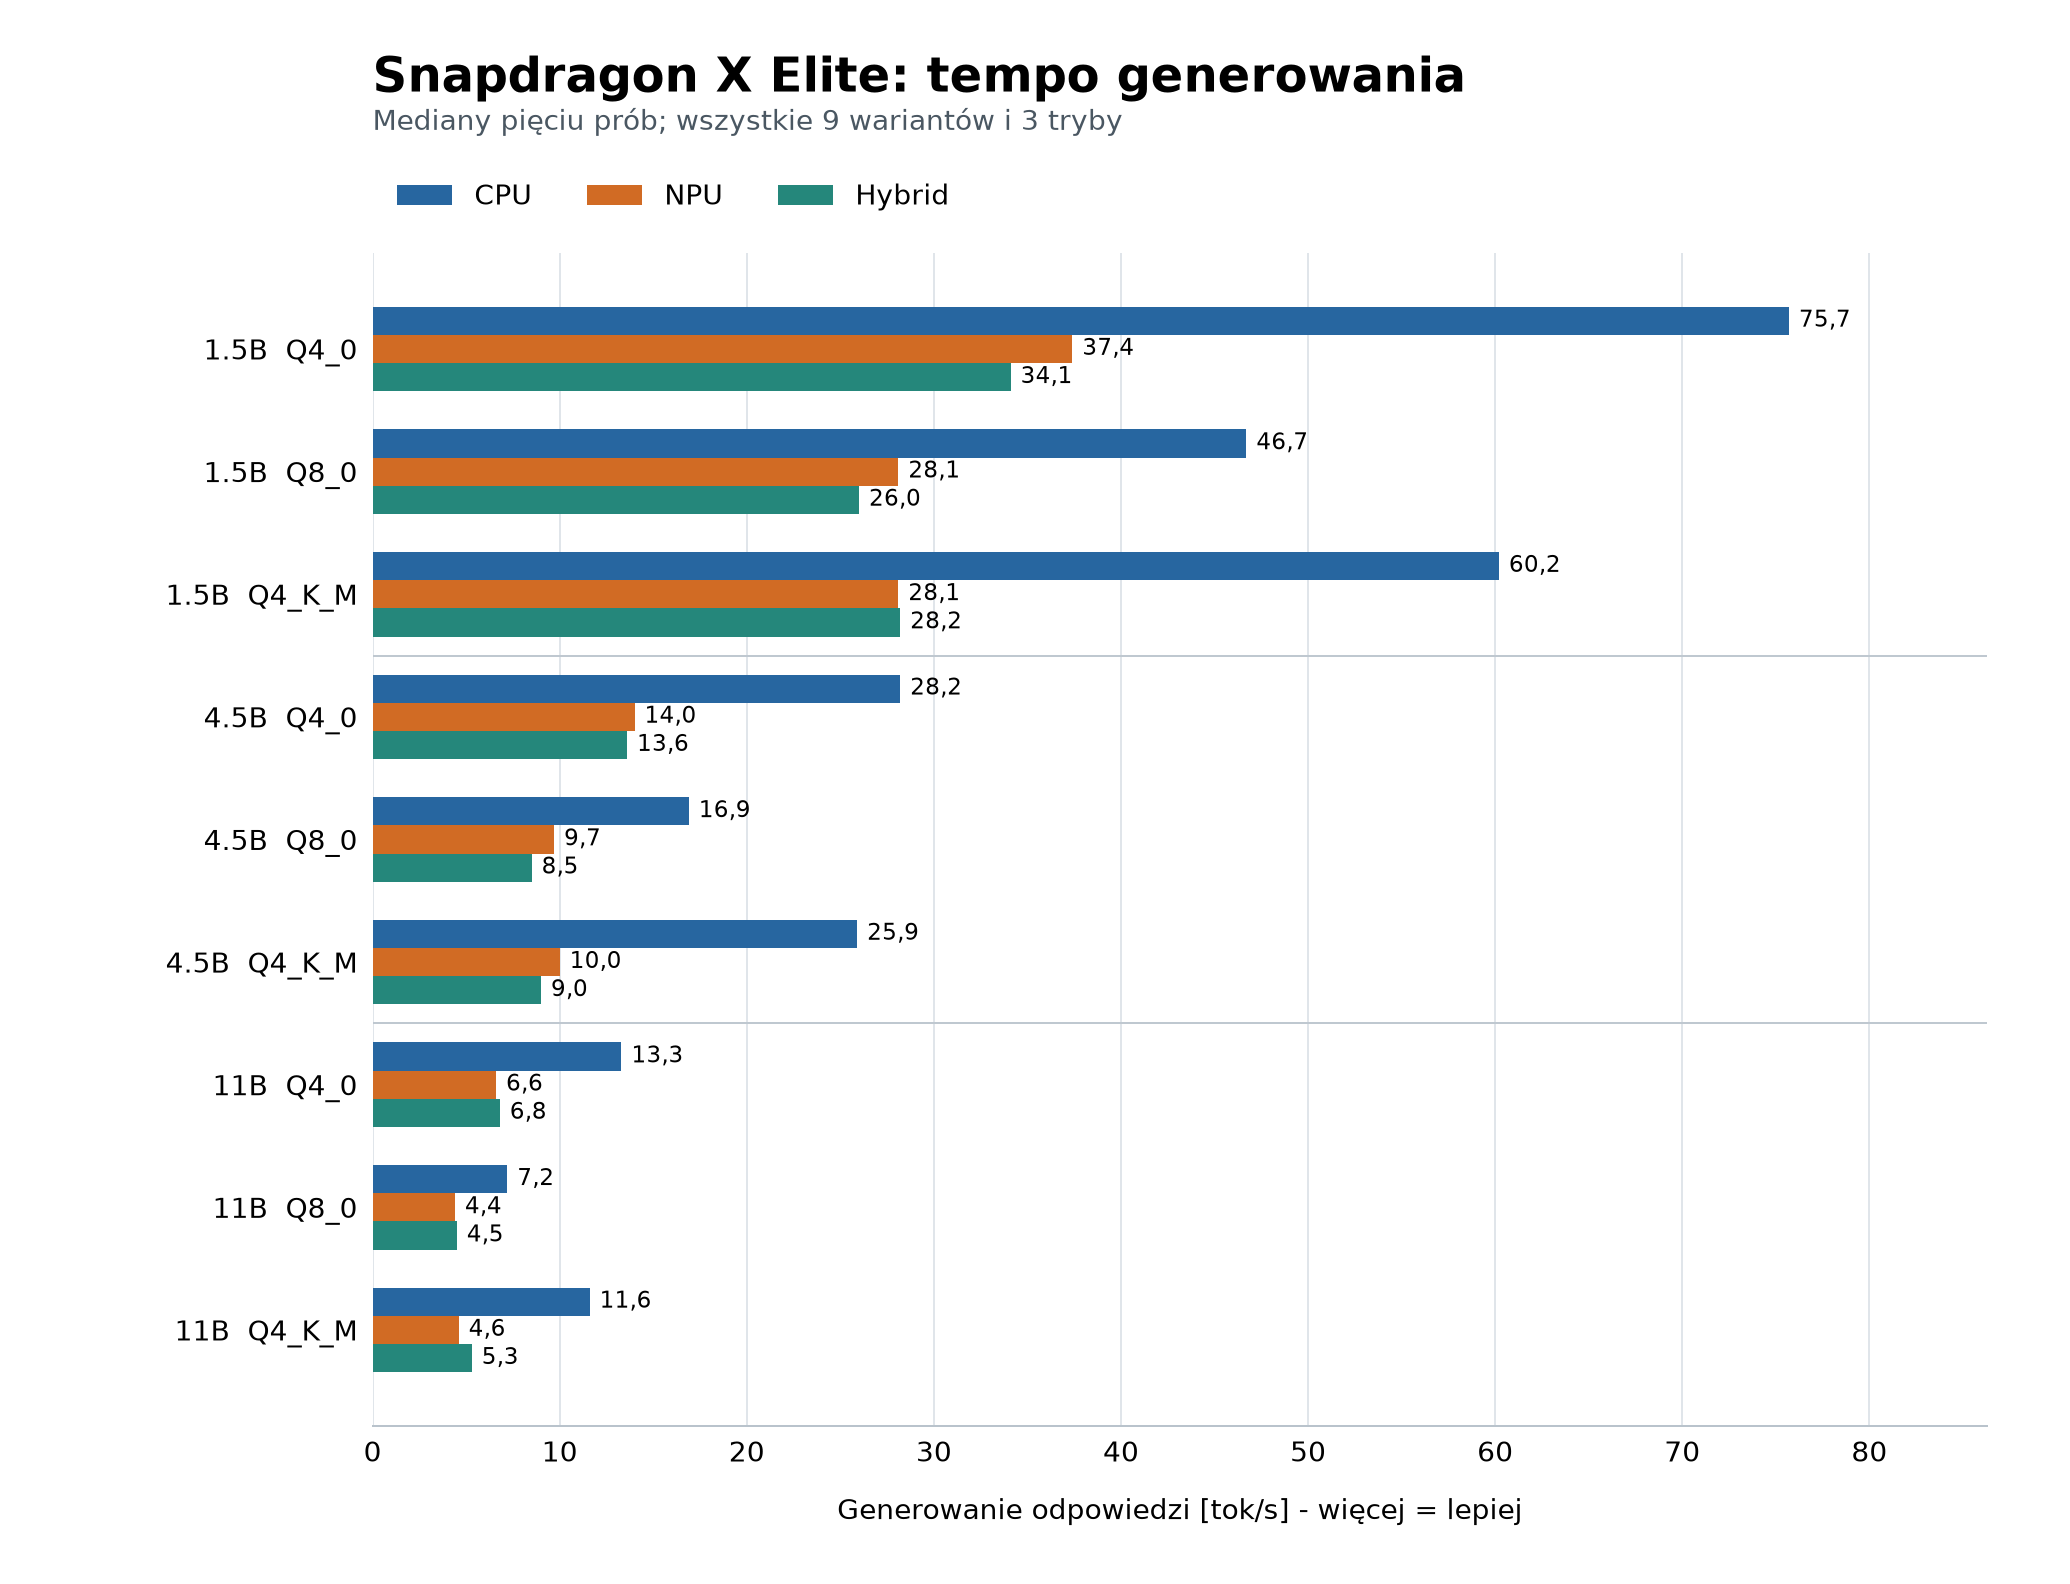
| Model | Kwantyzacja | CPU | NPU | Hybrid |
|---|---|---|---|---|
| 1.5B | Q4_0 | 75,7 | 37,4 | 34,1 |
| 1.5B | Q8_0 | 46,7 | 28,1 | 26,0 |
| 1.5B | Q4_K_M | 60,2 | 28,1 | 28,2 |
| 4.5B | Q4_0 | 28,2 | 14,0 | 13,6 |
| 4.5B | Q8_0 | 16,9 | 9,7 | 8,5 |
| 4.5B | Q4_K_M | 25,9 | 10,0 | 9,0 |
| 11B | Q4_0 | 13,3 | 6,6 | 6,8 |
| 11B | Q8_0 | 7,2 | 4,4 | 4,5 |
| 11B | Q4_K_M | 11,6 | 4,6 | 5,3 |
CPU wygrywało decode we wszystkich tych konfiguracjach. Dla 11B Q4_0 było około dwukrotnie szybsze od trybu NPU. Nie oznacza to jednak, że NPU przegrywało każdy etap odpowiedzi. Dla Q4_0:
| Model | TTFT CPU | TTFT NPU | Prefill CPU | Prefill NPU |
|---|---|---|---|---|
| 1.5B | 142 ms | 131 ms | 749 tok/s | 810 tok/s |
| 4.5B | 473 ms | 319 ms | 224 tok/s | 333 tok/s |
| 11B | 1492 ms | 732 ms | 108 tok/s | 220 tok/s |
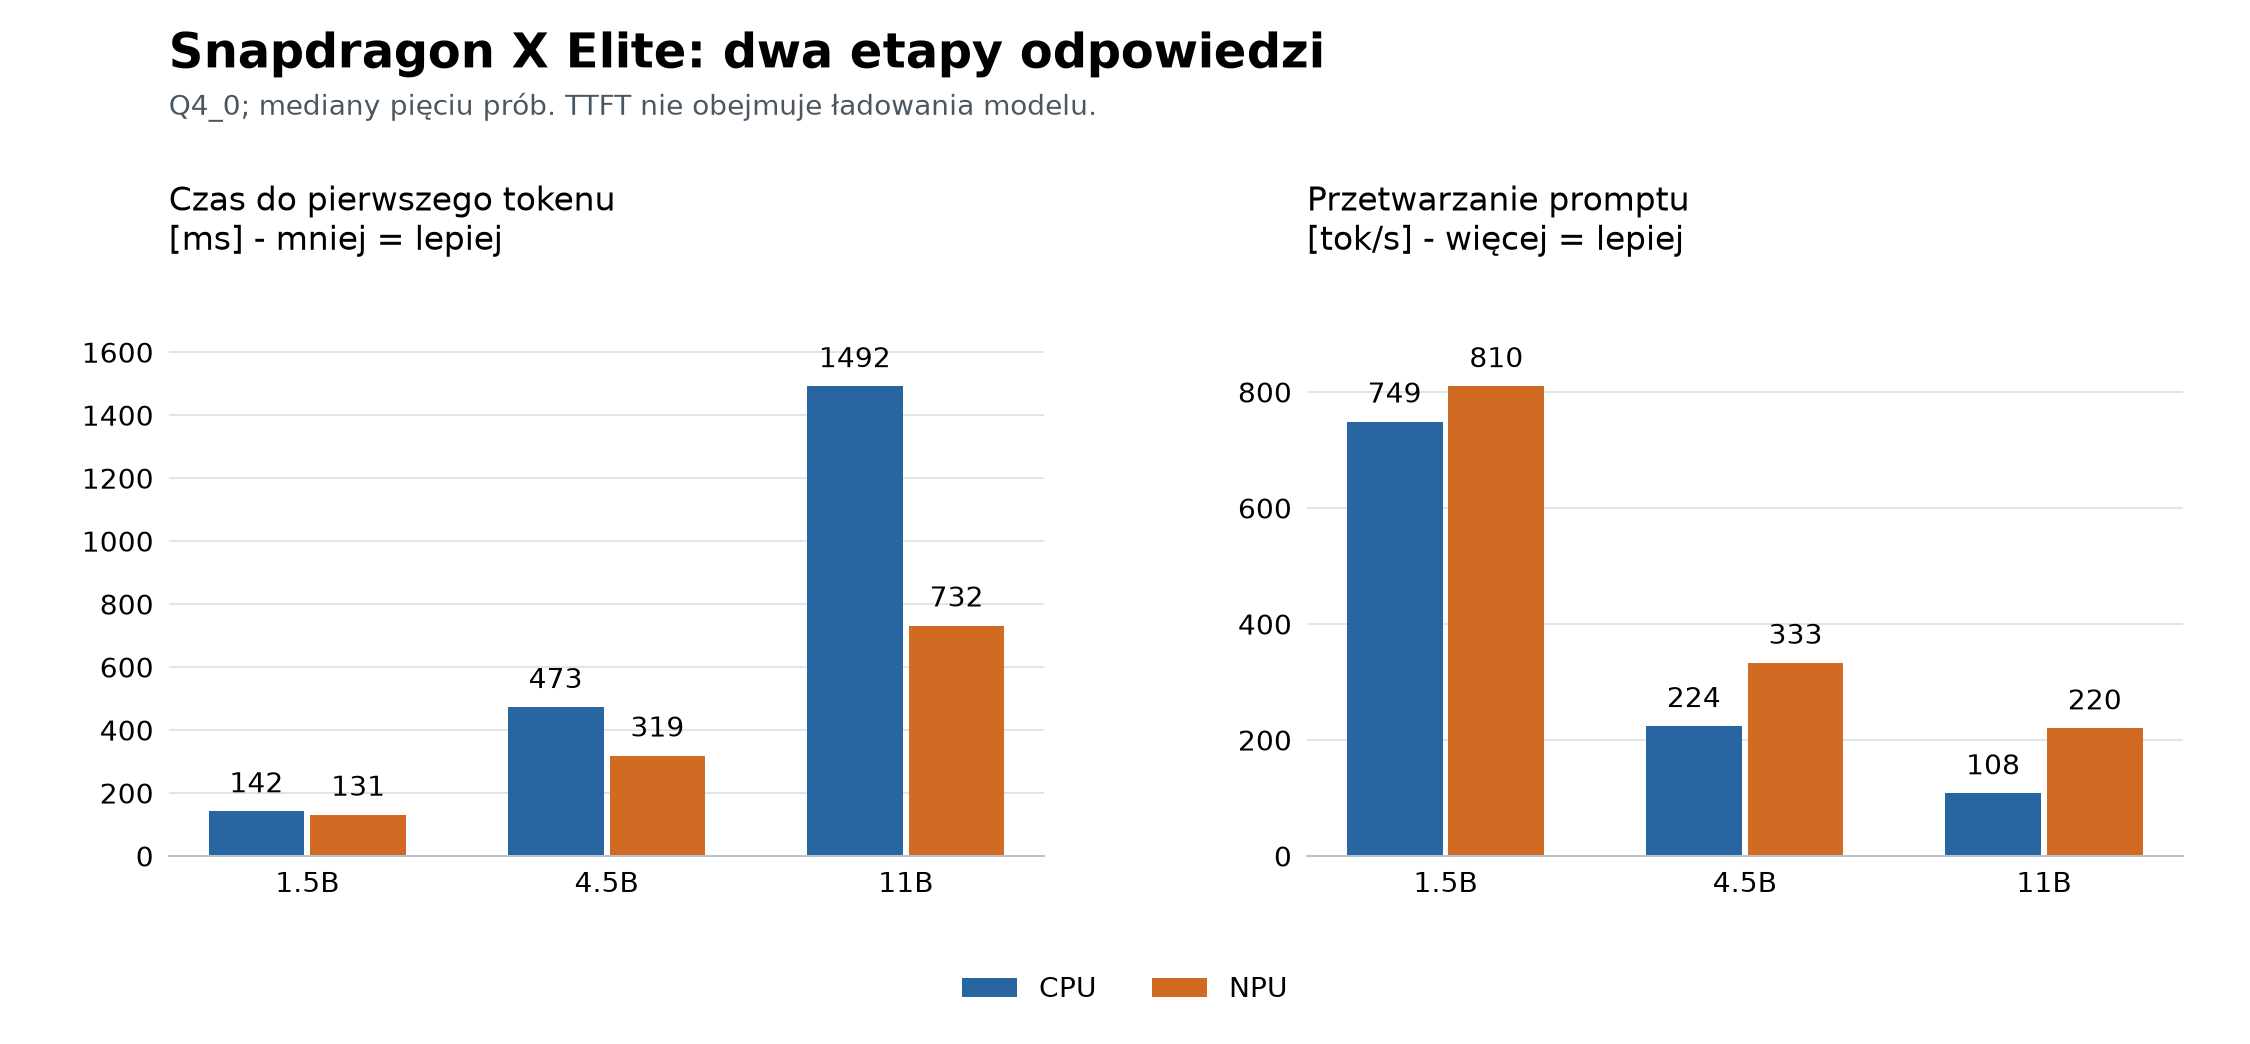
NPU szybciej przetwarzało wejście. Wybór zależy więc również od tego, czy czekam na początek odpowiedzi, czy na jej ukończenie. Przy tym krótkim wejściu i dłuższej odpowiedzi większe tempo decode przemawiało za CPU. Nie mierzyłem tutaj serii długich dokumentów, która mogłaby zmienić bilans.
hybrid nie dał przewagi nad CPU w decode.
5.2. VENTUNO Q: NPU daje praktyczną różnicę
Na płytce układ sił się odwrócił. Dla działających konfiguracji podaję kolejno decode tok/s / prefill tok/s / TTFT ms. Każda liczba jest medianą pięciu prób.
| Model | Kwantyzacja | NPU | CPU | Hybrid |
|---|---|---|---|---|
| 1.5B | Q4_0 | 29,1 / 657 / 162 | 15,9* / 76,5 / 1385 | 13,8 / 138 / 767 |
| 1.5B | Q8_0 | 19,7 / 618 / 172 | 9,7 / 56 / 1886 | 9,7 / 134 / 792 |
| 1.5B | Q4_K_M | 24,5 / 626 / 170 | 12,3 / 40 / 2666 | 6,0 / 89 / 1193 |
| 4.5B | Q4_0 | 11,5 / 233 / 456 | 5,4 / 23 / 4534 | 5,5 / 51 / 2071 |
| 4.5B | Q8_0 | Błąd ładowania | 3,2 / 16 / 6498 | Błąd ładowania |
| 4.5B | Q4_K_M | 9,2 / 244 / 437 | 5,0 / 12 / 8751 | 2,9 / 32 / 3316 |
| 11B | Q4_0 | Błąd ładowania | 2,4 / 12 / 13236 | Błąd ładowania |
| 11B | Q4_K_M | Błąd ładowania | 2,1 / 5,7 / 28488 | Błąd ładowania |
Najbardziej interesuje mnie 4.5B Q4_0. NPU generowało około 2,1 razy szybciej niż CPU, a pierwszy token pojawiał się około dziesięć razy wcześniej. Q4_K_M również działało, ale decode wyniosło 9,2 zamiast 11,5 tok/s. Dla 1.5B Q8_0 i Q4_K_M NPU było około dwukrotnie szybsze od CPU w decode.
To nadal nie znaczy, że płytka pokonała laptop. Na laptopie 4.5B Q4_0 na CPU dawało 28,2 tok/s. Wynik mówi przede wszystkim, który tryb wybrać na danym urządzeniu, a nie że nowszy Hexagon automatycznie jest szybszy we wszystkim.
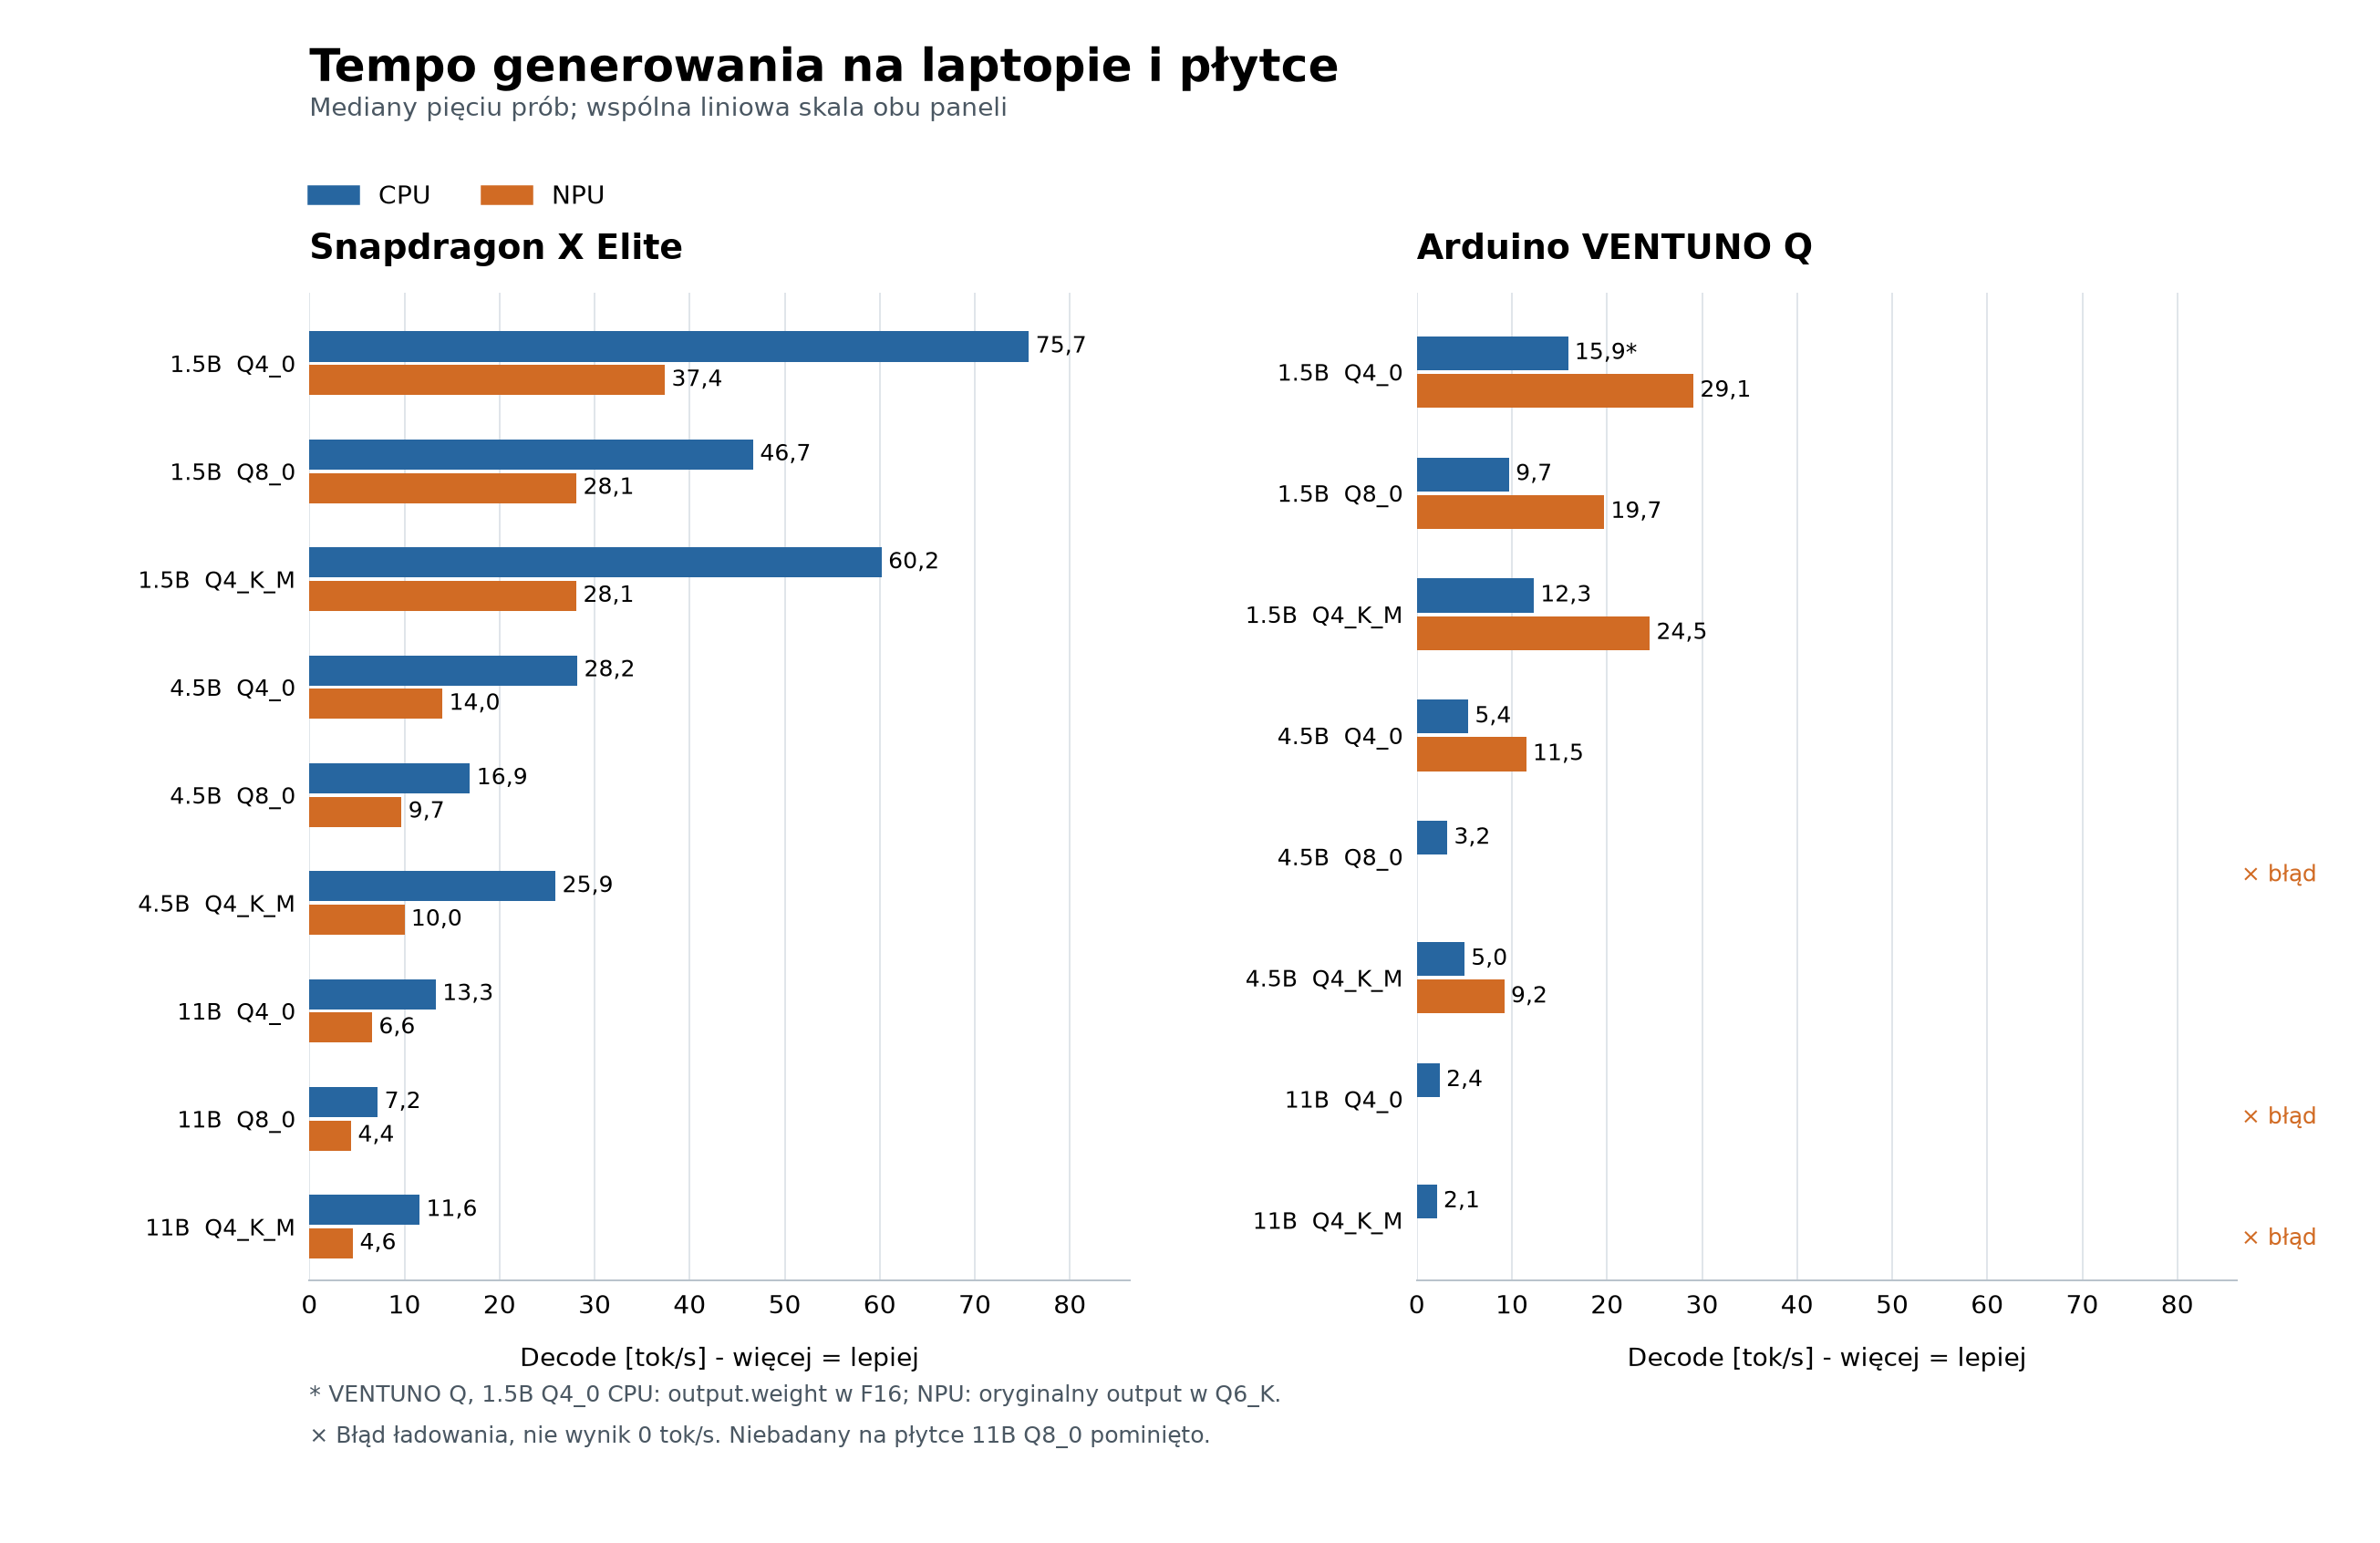 *Mediany pięciu prób. Krzyżyki oznaczają błąd ładowania, nie zerową szybkość.
11B Q8_0 na płytce nie było testowane. Gwiazdka przy 1.5B CPU oznacza ponowny
pomiar z tensorem wyjściowym F16.*
5.3. Dlaczego większe modele nie przeszły ładowania?
| Model | Kwantyzacja | Rozmiar pliku | Próba NPU na VENTUNO Q |
|---|---|---|---|
| 1.5B | Q4_0 / Q8_0 / Q4_K_M | Około 0,9 / 1,7 / 1,0 GB | Generowanie działało |
| 4.5B | Q4_0 / Q4_K_M | 2,70 / 2,88 GB | Generowanie działało |
| 4.5B | Q8_0 | 5,06 GB | Błąd ładowania |
| 11B | Q4_0 / Q4_K_M | Około 6,3 / 6,7 GB | Błąd ładowania |
Największy załadowany wariant to 4.5B Q4_K_M (2,88 GB), najmniejszy, który nie przeszedł, to 4.5B Q8_0 (5,06 GB).
Błędy miały wspólną sygnaturę, np. dla 4.5B Q8_0:
ggml-hex: HTP0 buffer mapping failed : domain_id 3 size 58068992 fd 80 error 0x00000001
ggml-hex: fastrpc_mmap failed
SDKError(Model loading failed)
FastRPC pośredniczy w komunikacji hosta z DSP i mapowaniu współdzielonych buforów. Ten log mówi, że nie udało się zmapować bufora podczas ładowania. Rozmiar 58 068 992 bajtów dotyczy jednego bufora, nie całego modelu ani ilości wolnej pamięci.
Dokumentacja backendu Hexagon opisuje około 3,5 GB 32-bitowego okna adresów wirtualnych na sesję. To jednak nie jest maksymalny rozmiar pliku GGUF. Ten sam opis wyjaśnia dynamiczne mapowanie i odmapowywanie wag, dzięki któremu większy model może być wykonywany przez pojedynczą sesję. KV cache, czyli pamięć zachowanych kluczy i wartości uwagi dla tokenów kontekstu, oraz aktywne bufory również zajmują przestrzeń adresową.
Dodatkowa diagnostyka wspólnej ścieżki backendu wykazała nieudany przydział adresów IOVA po stronie hosta i propagację błędu ENOMEM do FastRPC.
Najbardziej prawdopodobne wyjaśnienie awarii większych wariantów to więc problem z przydziałem przestrzeni adresowej dla mapowań urządzenia. Dynamiczne mapowanie wag nie wystarczyło w tej konfiguracji do uruchomienia większych testowanych wariantów. Nie wyznaczyłem jednak sztywnego limitu rozmiaru GGUF ani nie rozstrzygnąłem, czy przydział adresów zawodzi przez zajęcie przestrzeni, fragmentację, wymagania wyrównania czy sposób utrzymywania mapowań.
Częściowe przeniesienie warstw na NPU albo inna wersja backendu pozostają kierunkami poszukiwania obejścia. Dokumentacja Qualcomma opisuje też podział grafu. Czy ta ścieżka uruchomi Bielika 11B na VENTUNO Q, dopiero trzeba sprawdzić.
5.4. Jaką cenę płacę za kwantyzację?
Poniżej zmiana accuracy względem F16 dla 1.5B/4.5B i BF16 dla 11B, w punktach procentowych. Znak minus oznacza gorszy wynik od referencji, plus lepszy wynik na tym zestawie. To te same 5174 przykłady dla każdej precyzji.
| Model | Kwantyzacja | polemo2_in | polemo2_out | klej_ner | cbd | belebele |
|---|---|---|---|---|---|---|
| 1.5B | Q4_0 | -3,9 | -4,0 | +2,2 | +0,4 | -2,4 |
| 1.5B | Q8_0 | +0,8 | -0,4 | -0,8 | +0,1 | +0,4 |
| 4.5B | Q4_0 | -2,4 | -7,5 | +5,5 | -2,8 | +0,3 |
| 4.5B | Q8_0 | +2,5 | +1,8 | -1,1 | -0,2 | -0,2 |
| 11B | Q4_0 | -0,7 | -1,2 | +0,6 | +3,1 | -0,2 |
| 11B | Q8_0 | -0,1 | +0,6 | -0,2 | +0,1 | -0,2 |
Na wykresie pokazuję absolutny wynik Belebele, czyli czytania ze zrozumieniem: 900 pytań w polskiej wersji. To przekrojowe zadanie językowe, bardziej pasujące do ogólnego porównania niż pojedynczy test sentymentu czy rozpoznawania kategorii nazw.
| Model | F16/BF16 | Q4_0 | Q8_0 |
|---|---|---|---|
| 1.5B | 60,6 | 58,1 | 61,0 |
| 4.5B | 77,8 | 78,1 | 77,6 |
| 11B | 86,1 | 85,9 | 85,9 |
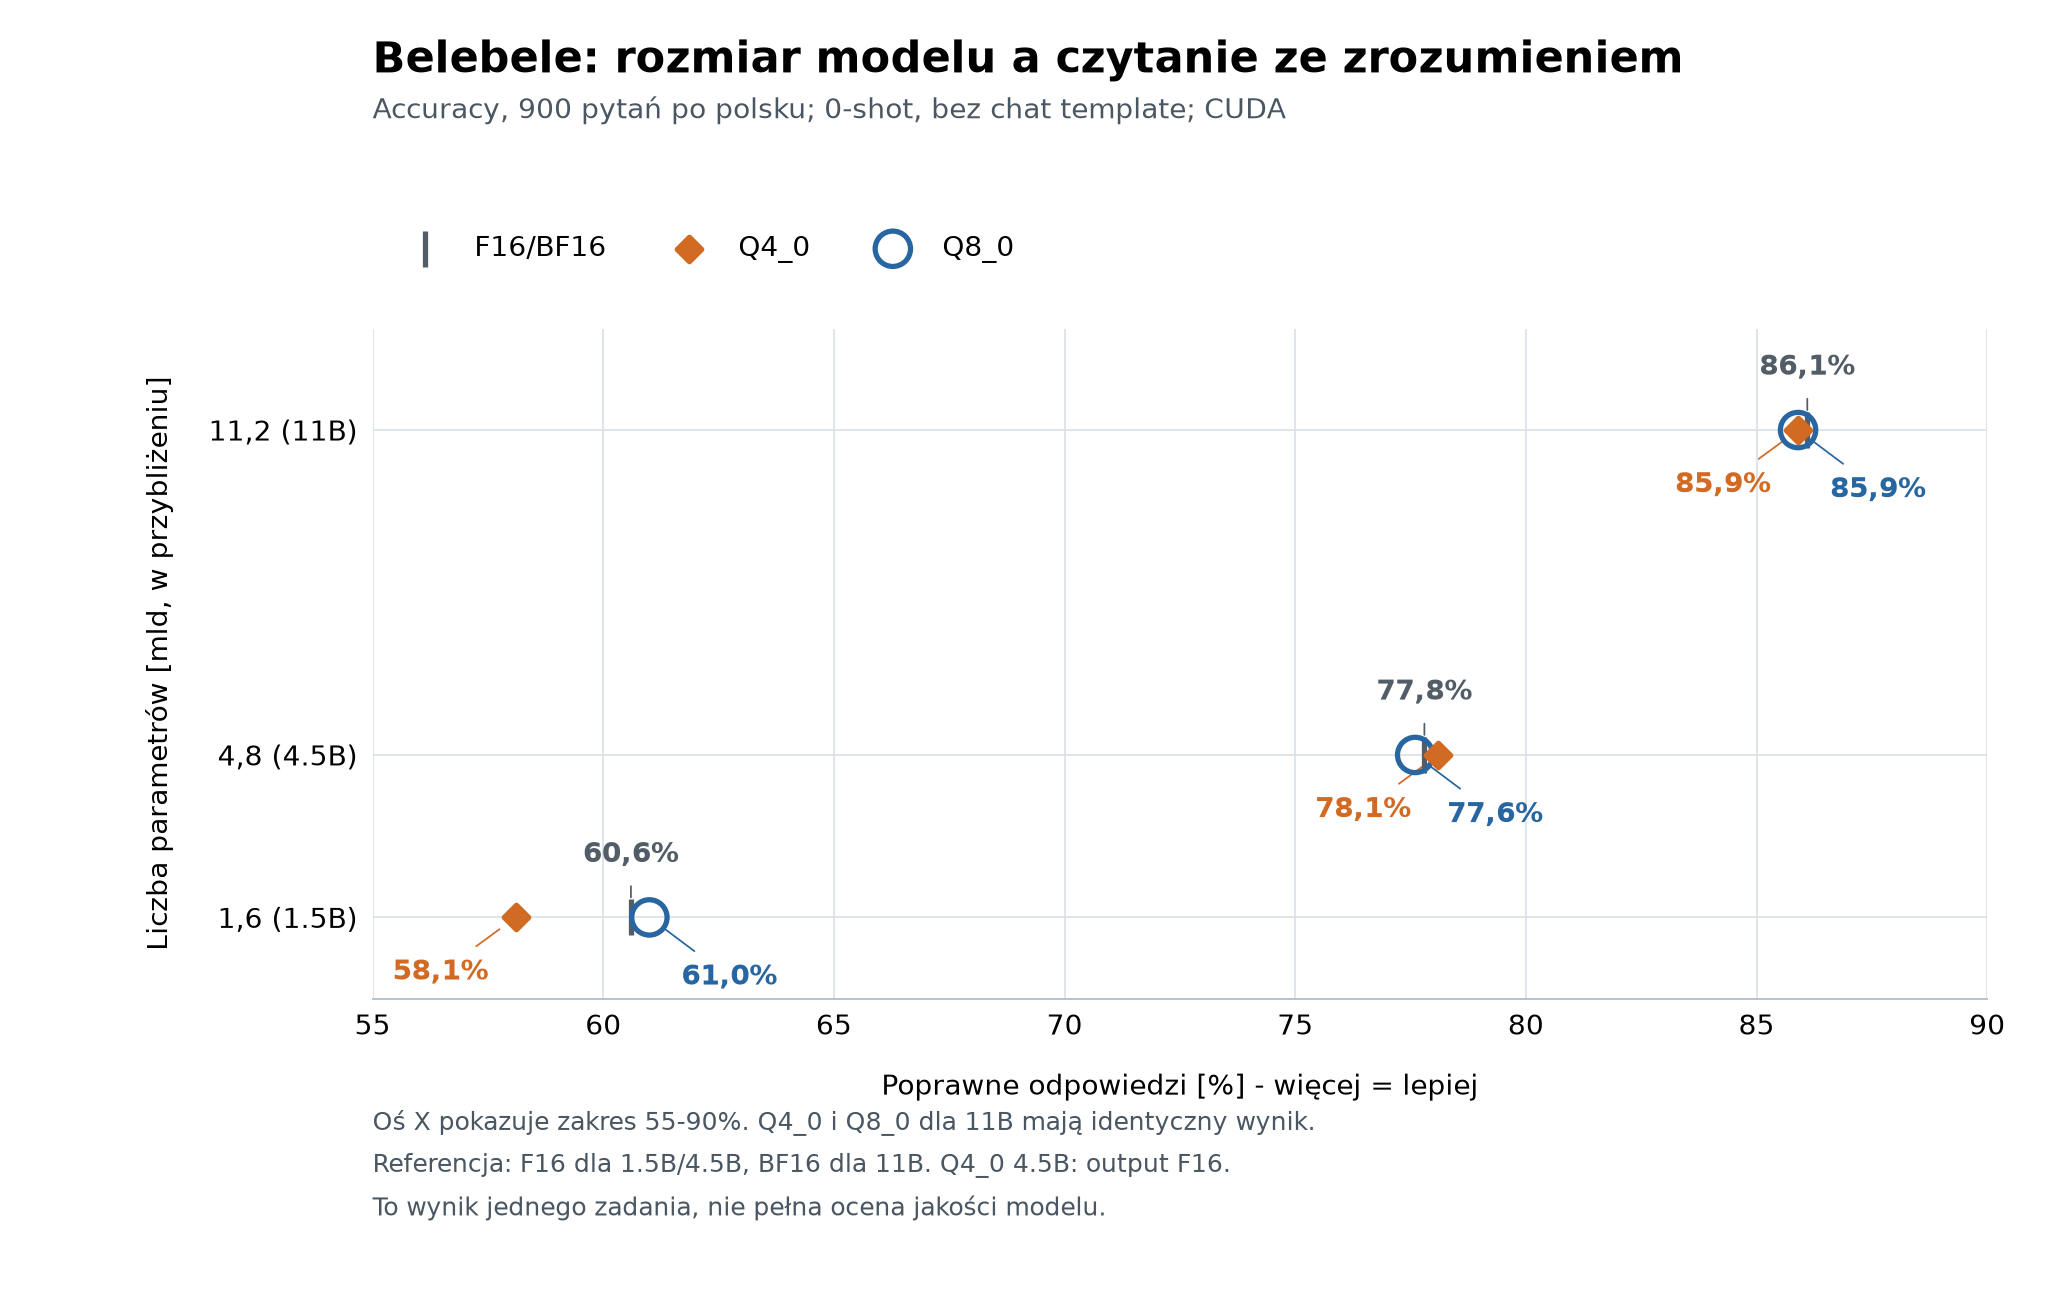
W tym zadaniu różnice między rozmiarami modeli są większe niż między badanymi precyzjami wag: 4.5B Q4_0 wypada wyraźnie lepiej niż 1.5B F16, a 11B Q4_0 pozostaje blisko swojego BF16. Nie oznacza to jednak, że kwantyzacja jest równie łagodna w każdym zadaniu, co widać w tabeli zmian powyżej.
Te wyniki mówią o odporności na kwantyzację, nie o całej jakości modelu.
Q8_0 pozostało blisko referencji: różnice nie przekroczyły około 2,5 p.p.,
najczęściej były mniejsze niż 1 p.p. Q4_0 zmieniało wyniki mocniej i nierówno:
4.5B straciło 7,5 p.p. w polemo2_out, ale zyskało 5,5 p.p. w klej_ner.
Skąd plusy po zmniejszeniu precyzji? Kwantyzacja zmienia oceny możliwych odpowiedzi. Jeśli dwie odpowiedzi mają podobne wyniki, nawet mała zmiana może odwrócić wybór: czasem na błędny, czasem na poprawny. Nie ma gwarancji, że accuracy spadnie w każdym zadaniu. To nie dowodzi, że mniej precyzyjny model stał się ogólnie lepszy. Nie traktuję też każdej małej różnicy jako istotnej poprawy lub straty.
Te liczby odpowiadają na pytanie: jak zmienił się wynik wybranych zadań po kwantyzacji przy stałym sposobie oceny? Nie sprawdzają swobodnej rozmowy, gramatyki generowanego tekstu, wywoływania narzędzi ani poprawności obliczeń NPU. Nie mierzyłem tu jakości Q4_K_M.
5.5. Ten sam plik, różne rezultaty: na CPU jeden token, na NPU pełna odpowiedź
Trafiłem na interesujący błąd podczas testowania kwantyzacji 1.5B Q4_0. Ten sam plik GGUF uruchomiony w różnych konfiguracjach zachowywał się różnie:
- CPU na płytce: jeden token, np. „O”, po czym EOS - znacznik końca odpowiedzi.
- NPU na płytce: 128 tokenów odpowiedzi, do ustawionego limitu.
- CPU na laptopie i PC: generowanie bez takiego przedwczesnego zakończenia.
Praktyczne obejście znalazłem w sposobie kwantyzacji: pozostawienie
output.weight w F16 przez --leave-output-tensor usuwało objaw w wykonanych
próbach CPU. Ta macierz zamienia stan modelu na wyniki dla wszystkich tokenów
słownika, w tym EOS, więc zmiana jej precyzji może zmienić wybór kolejnego tokenu.
Dla tego tensora 1.5B pozostawienie F16 zamiast Q6_K zwiększa zapis wag o około
55,3 MiB.
6. Jak przygotować GGUF i jego kwantyzacje
Przygotowanie składa się z dwóch kroków: zapisania wag w GGUF i zmniejszenia ich
precyzji przez kwantyzację. Używam narzędzi z llama.cpp.
Poniższe przykłady zakładają zainstalowane
zależności konwertera i zbudowany program llama-quantize.
6.1. Z wag Hugging Face do GGUF
Konwerter llama.cpp przepisuje model z formatu Hugging Face do GGUF: odczytuje konfigurację, tokenizer i wszystkie części wag, a następnie zapisuje je w formacie używanym przez llama.cpp. Jeśli mamy już gotowy GGUF, konwersja nie jest potrzebna. Katalog pobranego modelu musi zawierać wagi, konfigurację i tokenizer. Eksport 11B do BF16:
python3 llama.cpp/convert_hf_to_gguf.py models/Bielik-11B-v3.0-Instruct \
  --outfile Bielik-11B.bf16.gguf --outtype bf16
6.2. Z GGUF do Q4_0, Q8_0 i Q4_K_M
Program llama-quantize przyjmuje plik źródłowy, nazwę wyniku i typ kwantyzacji:
./llama.cpp/build/bin/llama-quantize Bielik-11B.bf16.gguf Bielik-11B.Q4_0.gguf Q4_0
./llama.cpp/build/bin/llama-quantize Bielik-11B.bf16.gguf Bielik-11B.Q8_0.gguf Q8_0
./llama.cpp/build/bin/llama-quantize Bielik-11B.bf16.gguf Bielik-11B.Q4_K_M.gguf Q4_K_M
Aby zachować tensor wyjściowy w jego oryginalnej precyzji:
./llama.cpp/build/bin/llama-quantize --leave-output-tensor \
  Bielik-11B.bf16.gguf Bielik-11B.Q4_0-lo.gguf Q4_0
To właśnie ta opcja usunęła przedwczesny EOS w 1.5B na CPU płytki (§5.5). Sama nazwa Q4_0 nie oznacza, że każdy tensor ma cztery bity. Składnię i opcje opisuje dokumentacja kwantyzatora.
6.3. Uruchomienie przez GenieX
Do próby na płytce wybieram działający wariant 4.5B Q4_0. Rejestruję katalog modelu i uruchamiam GenieX v0.9.3:
geniex pull local/bielik-4p5b-q4_0 \
  --model-hub localfs --local-path /home/arduino/bielik/4.5b/q4_0 \
  --model-type llm --skip-update

geniex infer local/bielik-4p5b-q4_0 \
  --compute npu --nctx 4096 --max-tokens 128 --think=false \
  --temperature 0.8 --seed 42 --input prompt.txt \
  --verbose --log info --skip-update
Zmiana --compute npu na --compute cpu pozwala sprawdzić ten sam plik na CPU.
Instalację GenieX opisuje tutorial Arduino.
7. Podsumowanie
To, że model uruchomił się, to nie wszystko. Musi on na dodatek działać odpowiednio szybko, żeby można było uznać go za użyteczny. Przyjąłem roboczy próg TTFT do 3 s i decode co najmniej 8 tok/s.
| Potrzeba | Mój punkt wyjścia | Dlaczego |
|---|---|---|
| Asystent na VENTUNO Q | 4.5B Q4_0 na NPU | Największy sprawnie działający model |
| Większy Bielik na laptopie | 11B Q4_0 na CPU | Największy dostępny Bielik - ~13,3 tok/s |
| Większy zapas szybkości na płytce | 1.5B Q4_0 na NPU | ~29,1 tok/s - mały model do sprawdzenia na docelowych zadaniach |
Na płytce wybrałbym NPU, na laptopie niekoniecznie. Dla działających wariantów 1.5B i 4.5B NPU płytki dawało praktyczną przewagę. Na X Elite CPU szybciej generowało kolejne tokeny. RTX 4090 posłużyła jako wspólny backend testów jakości, nie uczestnik rankingu szybkości tych urządzeń. Nie ma jednego „NPU zawsze wygrywa” - wynik zależy od modelu, urządzenia i oprogramowania.
Dla większego Bielika pozostaje problem uruchomienia. Badane 11B nie przeszły
ładowania w trybach npu i hybrid na płytce. Zarejestrowałem błąd mapowania
FastRPC. Diagnostyka wspólnej ścieżki wskazuje na nieudany przydział adresów IOVA
po stronie hosta (§5.3). Nie jest to dowód, że sprzęt nigdy nie obsłuży takiego
modelu ani że musi pomóc właśnie QNN.
Następny krok to sprawdzić wybraną konfigurację na rzeczywistych zadaniach asystenta. Dokładna diagnoza FastRPC, kompilacja QNN oraz audio i integracja z Home Assistantem pozostają osobnymi etapami.
Gotowe warianty Q4_0 publikuję na Hugging Face: Bielik-4.5B-v3.0-Instruct-GGUF-Q4_0 i Bielik-11B-v3.0-Instruct-GGUF-Q4_0.