W laptopie mam nieużywane NPU. Chcę wreszcie ustalić, czy może mi się do czegoś przydać
W swoim laptopie Lenovo Yoga Slim 7x mam oprócz standardowego CPU i GPU jeszcze jeden procesor: NPU (Neural Processing Unit), przeznaczony do energooszczędnego wykonywania obliczeń sieci neuronowych. Na co dzień ten NPU, może poza rozmywaniem tła podczas rozmowy czy indeksowaniem plików w tle, pozostaje bezczynny. Postanowiłem więc sprawdzić, co jeszcze da się z nim zrobić, jaką oferuje wydajność i czy w praktyce warto z niego korzystać.
Zacząłem od sprawdzenia, jakie modele językowe można na nim uruchomić, przez jakie narzędzia, ile zachodu wymaga przygotowanie i czy rezultat jest wart tego wysiłku. Zmierzyłem szybkość generowania, czas oczekiwania na odpowiedź oraz zachowanie przy różnych długościach wejścia i stanach zasilania. Sprawdziłem też wybrane rozmiary modeli i kwantyzacje; nie uzyskałem wiarygodnego pomiaru zużycia RAM.
Mam nadzieję, że lokalny LLM przyda się tam, gdzie połączenie z chmurą jest słabe albo nie ma go wcale, na przykład w samolocie lub w pociągu. Być może wystarczy do pomocy przy tekście, kodzie lub notatkach zapisanych na laptopie. Warto też wiedzieć, jakie zadania da się wykonać bez przesyłania promptu do zewnętrznego modelu. W takich warunkach NPU może okazać się szczególnie przydatne: powstało właśnie po to, by obliczenia sieci neuronowych wykonywać oszczędniej niż CPU i GPU, a ASUS wprost łączy je z niskim zużyciem energii i dłuższą pracą na baterii (ASUS). Sprawdziłem więc szybkość i przybliżoną moc działających konfiguracji; czasu pracy na baterii nie mierzyłem.
Nie zakładałem, że lokalny model zastąpi chmurę ani że NPU musi wygrać z CPU lub GPU. Celem było ustalenie, kiedy warto użyć NPU, którą ścieżkę wybrać i gdzie kończy się jego praktyczna użyteczność. Przewaga CPU lub GPU w konkretnym scenariuszu była równie wartościowym wynikiem.
Dodatkową motywacją jest dla mnie chęć lepszego poznania technologii i chęć poeksperymentowania z parametrami modeli.
Punktem startowym był Qwen3-4B-Instruct-2507. Następnie sprawdziłem wybrane rozmiary modeli, kwantyzacje, pojemności okna i rzeczywiste długości wejścia. Porównania dotyczą natywnego Windows ARM64 na tym laptopie.
Najważniejsze wyniki:
- Krótkie wejście, zasilacz: CPU z Q4_0 daje około 33 tok/s — najszybciej.
- Bateria + Power Saving: NPU (qairt) utrzymało około 20 tok/s — najwyższe tempo decode spośród badanych konfiguracji w tym trybie.
- Długie wejście (6180 tokenów): generacja około 33 s na NPU wobec około 86 s na CPU.
- Rozmiar modelu: 8B i 14B osiągnęły tempo użyteczne do interaktywnej pracy; 32B (około 4,8 tok/s) było dla mnie zbyt wolne do wygodnego czatu.
- NPU nie jest automatycznie najlepszym wyborem — zależy od scenariusza.
Odczyty mocy na poniższym wykresie to przybliżenia netto kanału SYS z osobnych, pojedynczych prób, z odpowiedziami różnej długości i treści. Dokładny zakres licznika i błąd pomiaru nie są ustalone. Nie są to pomiary czasu pracy na baterii ani energii jednakowego zadania.
Dłuższe wejście może zmienić wybór urządzenia. Przy 420 tokenach wejścia CPU kończył generację wcześniej: 6,69 s wobec 9,31 s na NPU. Przy 6180 tokenach NPU potrzebowało 32,96 s, a CPU 86,03 s — w tym teście NPU było około 2,6× szybsze.
1. Podstawowe informacje
1.1. Sprzęt
Testuję Yoga Slim 7x ze Snapdragonem X Elite X1E-78-100 i 32 GB RAM. W jednym SOC są trzy urządzenia, na których można wykonywać obliczenia modelu.
Laptop wyposażony jest w procesor Qualcomm Snapdragon X Elite z trzema jednostkami obliczeniowymi:
- CPU - 12 rdzeni Qualcomm Oryon, podzielonych na trzy klastry po cztery rdzenie, taktowanie do 3,4 GHz przy pracy wielordzeniowej.
- GPU - zintegrowany Qualcomm Adreno X1-85, korzystający ze współdzielonej pamięci RAM, z obsługą OpenCL.
- NPU - Qualcomm Hexagon o deklarowanej wydajności do 45 TOPS (bilionów operacji na sekundę).
TFLOPS i TOPS nie da się łatwo przeliczyć na tokeny/s. Szybkość generowania zależy też od modelu, przesyłania danych z pamięci i implementacji obliczeń. Trzeba ją zmierzyć dla konkretnej konfiguracji.
1.2. Modele i pliki
Wykorzystane modele
W testach wykorzystałem głównie Qwen3-4B-Instruct-2507. Oznaczenie 4B w jego nazwie oznacza około czterech miliardów parametrów. Ta wersja modelu działa wyłącznie w trybie non-thinking. Mniejszy model nie jest po prostu mocniej skwantyzowanym wariantem większego. Ma inną liczbę parametrów, a poszczególne modele mogą różnić się również architekturą i treningiem.
Dla porównania zmierzyłem też Qwen3-1.7B, 8B, 14B i 32B na CPU z wyłączonym trybem thinking.
Podjąłem również próbę uruchomienia Qwen3-235B-A22B Q4_K_M, modelu typu MoE (Mixture of Experts). W tej architekturze router wybiera część ekspertów do przetwarzania danego tokenu. Oznaczenie 235B-A22B mówi o około 235 miliardach parametrów łącznie i około 22 miliardach aktywnych przy przetwarzaniu tokenu. Nie oznacza to jednak, że wystarczy pamięć na wagi modelu 22B. W mojej próbie model nie przeszedł etapu ładowania, więc nie mam dla niego wyniku szybkości.
Formaty plików modeli
Modele zapisywane są w różnych formatach, które różnią się zawartością plików i ich ilością nawet jeśli sam model jest ten sam. Dlatego ten sam model, np. Qwen, można pobrać w kilku wersjach. Poniżej opisuję najważniejsze formaty i różnice między nimi.
Pliki wag PyTorch
W starszych repozytoriach na Hugging Face często spotkamy pliki takie jak pytorch_model.bin (a także z rozszerzeniami .pt i .pth), zapisane mechanizmem serializacji PyTorcha. Wykorzystuje on pod spodem pythonowy moduł pickle. Z powodu możliwości egzekucji złośliwego kodu (ACE) format ten jest obecnie wypierany przez bezpieczniejsze alternatywy.
Safetensors
Format powstał jako bezpośrednia odpowiedź na luki w plikach .bin. Plik .safetensors to płaski bufor binarny zawierający wyłącznie nazwy tensorów, ich typy, wymiary i wartości. Dobrze nadaje się do bezpiecznego udostępniania wag modelu, ale nie zapisuje kompletnego przepisu na architekturę obliczeń modelu.
GGUF
GGML to biblioteka obliczeń tensorowych używana m.in. przez llama.cpp. GGUF jest formatem zapisu modeli z tego ekosystemu. GGUF może zawierać nie tylko wagi (w tym skwantyzowane), ale też rozszerzalne metadane: nazwę architektury, jej parametry, tokenizer i szablon rozmowy.
Konteksty QNN i DLC
Zamiast przekazywać programowi same wagi, można wcześniej przygotować obliczenia pod akcelerator. Narzędzia Qualcomma przyjmują opis sieci i jej wagi, przekształcają obliczenia do postaci obsługiwanej przez wybrany backend i pozwalają zapisać rezultat. Taki zapis to kontekst QNN.
W paczkach dla układów Hexagon kontekst jest często podzielony na pliki .bin (uwaga: to zupełnie inny format niż opisany wcześniej .bin PyTorcha!) .DLC (Deep Learning Container) to z kolei dedykowany kontener Qualcomma do zapisania sieci, który również może zawierać przygotowany kontekst.
Skąd program wie, jak z tych plików zbudować sieć?
Mechanika budowania sieci zależy od formatu oraz ekosystemu, w którym dany model uruchamiamy:
- Hugging Face (Safetensors / PyTorch): Pliki wag dostarczają tylko liczby. W typowym repozytorium obok wag znajduje się plik
config.json, który określa typ architektury i jej parametry (np. liczbę warstw i rozmiary wektorów). Kod wykonujący tę architekturę znajduje się zwykle w zewnętrznej bibliotecetransformers. Klasa taka jakAutoModelForCausalLModczytuje konfigurację (wskazującą np. naQwen3ForCausalLM), tworzy szkielet sieci i dopiero wtedy wczytuje do niego wagi. Tokenizer dostarczany jest jako osobne pliki. - GGML (GGUF): Kod architektury nie jest pobierany z biblioteki Transformers, lecz jest wbudowany bezpośrednio w program (np.
llama.cpp). Program odczytuje z pliku GGUF, że ma uruchomić np. architekturę Qwen3, pobiera zaszyte w kontenerze ustawienia sieci i używa własnej, wewnętrznej implementacji do ułożenia obliczeń (implementacja Qwen3 w llama.cpp). Dlatego nowa architektura wymaga aktualizacji kodu samego programu, a nie tylko konwersji wag do formatu GGUF. - Qualcomm (QNN/DLC): Program ładuje gotowe, prekompilowane instrukcje dla akceleratora przez interfejs wykonawczy QNN. Nie musi budować architektury warstwa po warstwie i mapować do nich wag tak jak robi to Transformers czy llama.cpp. Wymaga to zazwyczaj załadowania gotowych kontekstów
.bin, konfiguracji paczki i tokenizera.
ONNX: graf obliczeń i jego wykonanie
ONNX, czyli Open Neural Network Exchange, powstał jako wspólna reprezentacja modeli, umożliwiająca przenoszenie ich między narzędziami. Nie jest biblioteką liczącą model. Opisuje obliczenia niezależnie od konkretnej implementacji sprzętowej.
W modelu ONNX znajdziemy:
- operacje i połączenia między nimi,
- wejścia i wyjścia, ich typy i wymiary oraz wersje używanych zestawów operatorów,
- wagi i stałe lub odwołania do osobnych plików danych.
Na prostym przykładzie:
x → MatMul z W → Add z b → Relu → ySafetensors może zapisać W i b. Plik ONNX zawiera strukturę całego grafu, wejścia/wyjścia, oraz same wagi. Runtime nadal musi wiedzieć, jak wykonać MatMul, Add i Relu.
ONNX to opis grafu, na podstawie którego runtime przygotowuje wykonanie. W ONNX Runtime wygląda to w uproszczeniu tak:
- Optymalizacja: ORT wczytuje graf i na poziomie oprogramowania upraszcza go – np. pre-kalkuluje stałe fragmenty lub łączy kilka sąsiadujących operacji w jedną szybszą.
- Dzieli pracę między Execution Providers, czyli integracje z backendami i akceleratorami. Np. na Snapdragonie interesuje mnie QNN Execution Provider.
- Provider przygotowuje obsługiwane fragmenty dla swojego backendu, a runtime organizuje ich wykonanie. Operacje mogą być realizowane przez gotowe kernele lub przygotowany silnik, nie przez bezpośrednie wykonywanie instrukcji ONNX.
Nieobsługiwane operacje mogą trafić na CPU, jeśli konfiguracja dopuszcza fallback, albo uruchomienie zostanie odrzucone.
Podsumowanie formatów
| Plik/format | Zawartość | Typowe oprogramowanie | Gdzie są wykonywane obliczenia? |
|---|---|---|---|
.safetensors |
Nazwane tensory, ich typy, wymiary i wartości. Także reprezentacje skwantyzowane, jeśli obsługuje je użyte narzędzie | PyTorch + Transformers (biblioteka zewnętrzna dostarcza kod architektury). | Na urządzeniach obsługiwanych przez dany stos. Sam format nie zapewnia ścieżki NPU na mojej Yodze |
pytorch_model.bin |
Zrzut obiektów z pamięci przez mechanizm serializacji PyTorcha (pickle) | PyTorch lub biblioteka korzystająca z niego | Zależnie od implementacji i backendów PyTorcha |
.gguf |
Tensory i metadane modelu, opcjonalnie tokenizer i szablon rozmowy | llama.cpp | CPU, GPU lub NPU, jeśli build i backend obsługują model oraz typy tensorów |
.onnx |
Niezależny od sprzętu graf operacji oraz powiązane z nim wagi | ONNX Runtime (ORT). | CPU, GPU lub NPU przez odpowiedni Execution Provider. Nie każdy graf działa na każdym urządzeniu |
Kontekst QNN .bin |
Zamknięte, skompilowane instrukcje dla konkretnego sprzętu | Interfejs QNN (np. z pluginem qairt). | W omawianej ścieżce backend HTP i Hexagon NPU |
.dlc |
Deep Learning Container – specyficzny kontener Qualcomma na sieć i ew. przygotowany kontekst. | Zgodne narzędzia i runtime Qualcomma | Wymaga ścisłej zgodności pliku z docelowym układem SoC i wersją oprogramowania. |
1.3. Czym uruchomić model na CPU, GPU i NPU?
W celu uruchomienia modelu na konkretnym hardware potrzebny jest runtime, który załaduje model i zorganizuje wykonanie, oraz backend obliczeniowy, który wykona obsługiwane operacje na danym urządzeniu.
llama.cpp
Jest to runtime odczytujący format GGUF. Implementuje on obsługiwane architektury modeli i zleca pracę backendom obliczeniowym. Na tej platformie interesują mnie trzy z nich: CPU, OpenCL (dla GPU Adreno) oraz eksperymentalny ggml-hexagon (dla NPU Hexagon).
Ekosystem Qualcomma posługuje się własną terminologią dla poszczególnych warstw stosu:
| Nazwa | Rola |
|---|---|
| QNN | Niskopoziomowe API i warstwa backendów do kompilacji oraz wykonania grafów. |
| QNN HTP backend | Backend QNN kierujący obsługiwane obliczenia bezpośrednio do Hexagona. HTP to Hexagon Tensor Processor. |
| QAIRT | Szerszy stos SDK i narzędzi wykonawczych Qualcomma. |
| Genie | Wewnętrzny framework generatywny w ekosystemie Qualcomma. |
| GenieX | Narzędzia i SDK udostępniające elastyczne ścieżki wykonania (m.in. przez system pluginów). |
| ONNX Runtime GenAI | Wyższa warstwa oparta na ONNX Runtime, obsługująca m.in. pętlę generowania tokenów, sampling i KV Cache. |
GenieX
To udostępnione przez Qualcomma narzędzie do uruchamiania modeli, działające w oparciu o pluginy. Wykorzystuje m.in. llama_cpp dla plików GGUF oraz qairt dla przygotowanych paczek QNN. Obie te drogi zmierzyłem. Qualcomm określa GenieX jako społecznościową wersję Genie, ale nie są to nazwy zamienne. Genie obsługuje generowanie w innych integracjach, np. w ścieżce modeli NPU w AnythingLLM (gdzie aplikacja pobiera paczkę z konfiguracją Genie i prekompilowanymi plikami QNN).
Próby szybkości wykonałem przez GenieX. Choć podczas przygotowań sprawdzałem również samodzielny build llama.cpp, podane w dalszej części wyniki pochodzą z GenieX. Integracji Genie wewnątrz ORT nie mierzyłem.
Podsumowanie ścieżek wykonania i dróg do sprzętu:
| Wersja artefaktu | Oprogramowanie / integracja | Droga do urządzenia |
|---|---|---|
| GGUF | Samodzielne llama.cpp lub GenieX z pluginem llama_cpp |
Backend CPU → rdzenie Oryon |
| GGUF | Samodzielne llama.cpp lub GenieX z pluginem llama_cpp |
Backend OpenCL → GPU Adreno |
| GGUF | Samodzielne llama.cpp lub GenieX z pluginem llama_cpp |
ggml-hexagon → NPU Hexagon |
| Paczka kontekstów QNN | GenieX z pluginem qairt |
QNN → backend HTP → NPU Hexagon |
| Przygotowany model ONNX dla QNN | ONNX Runtime GenAI z QNN EP | QNN → backend HTP → NPU Hexagon |
| Paczka zgodna ze ścieżką Genie w ORT | ORT GenAI z backendem Genie | Stos Qualcomma → NPU Hexagon |
Powyższe ścieżki zostały szerzej opisane w dokumentacji GenieX oraz przewodniku ORT GenAI po QNN i Genie.
Uruchomienie modelu GGUF na Hexagonie nie wymaga uprzedniej konwersji do ONNX ani przechodzenia przez QNN. Z kolei fakt, że dwie inne ścieżki wykorzystują wspólne QNN, nie gwarantuje identycznej szybkości ani zamienności paczek.
CPU steruje układem NPU, organizuje tokenizację tekstu i odpowiada za sampling. Jest to przewidywane i nie jest to to samo, co fallback obliczeń zrzuconych awaryjnie z akceleratora.
1.4. Kwantyzacja
Kwantyzacja przybliża wartości liczbowe, używając ograniczonej reprezentacji. Mniej bitów może oznaczać mniejszy plik, mniejszy koszt pamięci i mniej danych do przesłania. Nie gwarantuje przyspieszenia, bo backend musi mieć wydajną implementację danego schematu. Może też zmienić odpowiedzi modelu.
| Oznaczenie | Co w rzeczywistości oznacza? |
|---|---|
| BF16 / F16 | Brak kwantyzacji (16-bit). Pełne wagi. Zapis BF16 zachowuje szerszy zakres liczb kosztem precyzji ułamków, a F16 odwrotnie. |
| Q8_0 | Kwantyzacja blokowa w GGML. Przybliżenia wag są zapisywane jako 8-bitowe kody ze wspólną skalą dla bloku. Nie jest to proste obcięcie oryginalnego zapisu każdej wagi do 8 bitów. |
| Q4_0 | Kwantyzacja blokowa w GGML. Przybliżenia wag są zapisywane jako 4-bitowe kody ze wspólną skalą dla bloku. Zmniejsza rozmiar reprezentacji i może zmienić jakość odpowiedzi; wpływu na jakość nie mierzyłem w tych testach. |
| Q4_K_M | Mieszany wariant kwantyzacji w GGML. Łączy Q4_K z wyższą precyzją wybranych tensorów, m.in. Q6_K. Może oferować inny kompromis rozmiaru, szybkości i jakości niż Q4_0, ale nie ustaliłem tu najlepszego wariantu pod względem jakości. |
| W4A16 (w QNN) |
Etykieta precyzji w recepturze Qualcomma. Nominalnie oznacza wagi INT4 oraz aktywacje INT16. Nie jest formatem pliku ani bezpośrednim odpowiednikiem schematu Q4_0 z GGML. |
Nie oceniałem jakości odpowiedzi, więc te oznaczenia i wyniki szybkości nie wyznaczają rankingu jakości ani optymalnego kompromisu rozmiaru i jakości.
Co w praktyce oznacza kwantyzacja „4-bitowa”?
To nie jest tak, że każda oryginalna waga zapisywana jest jako osobna, precyzyjna liczba zajmująca równo 4 bity. Kwantyzacja to kompresja blokowa – zapisujemy jedynie przybliżenie wagi za pomocą krótkiego kodu i mnożnika (skali), który pozwala odtworzyć jej orientacyjną wartość w locie. Same 4 bity dają zaledwie 16 możliwych stanów.
W schemacie Q4_0 wagi grupowane są po 32 sztuki. Taki blok dzieli ze sobą jedną wspólną, 16-bitową skalę:
Struktura pojedynczego bloku Q4_0:
[ skala: 2 bajty ] + [ 32 kody po 4 bity: 16 bajtów ]

Razem: 18 bajtów na 32 wagi.
Daje to średnio 4,5 bitu na każdy parametr modelu.
Skala i kody muszą pracować razem. Układ „Q4” opisuje konkretną strukturę blokową, a nie idealne matematyczne 4 bity pamięci na każdą pojedynczą wagę.
W4A16: wagi to nie wszystkie liczby w sieci
Podczas działania (inferencji) w pamięci operacyjnej pojawiają się dwa różne typy danych:
- Wagi (Weights - W): wyuczone parametry modelu. Są statyczne i podczas generowania tekstu tylko je odczytujemy.
- Aktywacje (Activations - A): tymczasowe wyniki obliczeń przekazywane między warstwami. Zmieniają się dynamicznie dla każdego przetwarzanego wejścia.
Zasada działania wygląda w uproszczeniu tak: aktywacje wejściowe × wagi → aktywacje wyjściowe.
W4A16 to etykieta precyzji, a nie format pliku. W recepturze Qualcomma oznacza to nominalnie: wagi jako liczby całkowite INT4 oraz aktywacje liczone w INT16 (a nie zmiennoprzecinkowym FP16). Etykieta ta określa pożądaną matematykę, ale nie definiuje samego układu bloków (jak robi to Q4_0), precyzji KV Cache, ani sposobu sumowania sprzętowego w NPU. Choć Q4_0 i W4A16 mają w nazwie czwórkę, oznaczają inną kwantyzację i inną warstwę abstrakcji.
Co właściwie porównuję?
Sprawdzam, co warto uruchamiać na CPU, GPU i NPU tego laptopa, z jaką kwantyzacją i w jakich warunkach. NPU było punktem wyjścia, ale nie zakładam, że będzie najlepszym wyborem. Pomiary wykonałem przez GenieX:
| Ścieżka w GenieX | Urządzenie lub tryb | Sprawdzone warianty 4B |
|---|---|---|
llama_cpp |
CPU | GGUF: F16, Q8_0, Q4_K_M, Q4_0 |
llama_cpp + OpenCL |
GPU Adreno | GGUF Q4_0 |
llama_cpp + ggml-hexagon |
NPU Hexagon | GGUF: F16, Q8_0, Q4_K_M, Q4_0 |
llama_cpp, tryb hybrid |
Tryb mieszany, bez zweryfikowanego podziału pracy | GGUF Q4_0 |
qairt + QNN HTP |
NPU Hexagon | Przygotowana paczka QNN W4A16 |
Osobno sprawdziłem modele od 1.7B do 32B na CPU, większą pojemność okna i dłuższe wejście. Porównałem też zachowanie na zasilaczu, baterii i z Power Saving.
Przy porównaniu tego samego GGUF między urządzeniami zachowuję ten sam plik modelu. Przejście na paczkę QNN zmienia także kwantyzację i runtime, więc ten wynik porównuje całe konfiguracje, nie wyłącznie sprzęt.
1.5. Jak czytać czas, kontekst i pamięć
- Prefill: przetworzenie wejścia.
- TTFT: czas od rozpoczęcia żądania do pierwszego tokenu odpowiedzi.
- Decode: tempo generowania kolejnych tokenów, podawane w tok/s.
Raportowane TTFT i czasy generacji nie obejmują ładowania modelu. Krótszy TTFT nie musi oznaczać szybszego ukończenia całej odpowiedzi.
Pojemność okna to nie długość wejścia. Wejście, historia, znaczniki rozmowy i odpowiedź dzielą budżet kontekstu. KV cache przechowuje część obliczeń dla zachowanych tokenów, ale dłuższa historia nadal zwiększa koszt pamięci i uwagi. Dlatego osobno zmieniam pojemność okna, a osobno faktyczną długość promptu.
Rozmiar pliku modelu nie jest równoznaczny ze zużyciem RAM. Do wag dochodzą cache, aktywacje, bufory i pamięć systemu. Nie uzyskałem wiarygodnego pomiaru RAM.
2. Co rzeczywiście udało się uruchomić
Najpierw zweryfikowałem, czy dane środowisko jest w ogóle w stanie zainicjować model i wygenerować odpowiedź. Do finalnych pomiarów wydajności trafiły wyłącznie stabilne, w pełni działające konfiguracje.
2.1. Bilans środowisk
| Środowisko | Wynik lokalnej próby uruchomienia | Czy podaję benchmark? |
|---|---|---|
| Samodzielne llama.cpp (ARM64) | CPU działa, OpenCL poprawnie wykrywa Adreno. Build z ggml-hexagon wykrywa NPU, ale nie otwiera sesji. |
Nie |
GenieX + llama_cpp |
Generowanie działa poprawnie we wszystkich trybach: CPU, GPU, NPU i hybrid. | Tak |
GenieX + qairt |
Prekompilowana paczka QNN (W4A16) poprawnie ładuje się i działa na NPU. | Tak |
| ONNX Runtime GenAI | Potencjalna alternatywa, jednak bez pomyślnie zakończonej, lokalnej próby generowania. | Nie |
Przebieg i problemy z uruchamianiem
Samodzielne llama.cpp
Kompilacja wersji ARM64 dla bazowego CPU zakończyła się sukcesem i działa stabilnie. Wariant z włączonym backendem ggml-hexagon wykrywa NPU, ale próba załadowania modelu kończy się błędem otwarcia sesji. Przyczyna błędu pozostaje nieznana, ale nie jest to dowód na brak sprzętowej obsługi tego modelu – ta sama ścieżka obliczeniowa zadziałała bezbłędnie przez biblioteki llama.cpp dostarczane wewnątrz GenieX.
GenieX z pluginem llama_cpp (GGUF)
Zarejestrowałem lokalny plik GGUF i wykonałem próbną inicjalizację NPU. Właściwe pomiary wydajności objęły tryby: CPU, GPU, NPU oraz hybrid. W trybie hybrid rzeczywisty podział pracy między bloki SoC pozostaje z perspektywy użytkownika czarną skrzynką.
GenieX z pluginem qairt (Paczka QNN)
Do testów użyłem przygotowanej paczki QNN W4A16 dla układów Snapdragon X Elite, zgodnej z pluginem qairt.
2.2. Czego nie mierzyłem
ORT rozpatrywałem jako alternatywę, ale jego sprawdzenie wymagałoby przygotowania lub pozyskania zgodnego modelu, konfiguracji generowania i zweryfikowania działania wybranej integracji. Byłby to osobny etap prac, wymagający dodatkowego czasu. Ograniczyłem więc zakres do działających konfiguracji GenieX. Brak wyników ORT jest decyzją o zakresie testów, nie dowodem, że ta droga nie działa.
3. Jak mierzę i co porównuję
Testowałem GenieX v0.10.0 z QAIRT 2.50 i dostarczoną z nim wersją llama.cpp.
Pomiary szybkości wykonałem natywnie na Windows ARM64 przez GenieX. Dla tabel szybkości i kwantyzacji każda ukończona komórka to jedna próba rozgrzewki i pięć mierzonych. Podaję medianę. Testy pojemności okna i długości wejścia mają po trzy mierzone próby. Ustawienia to limit 128 nowych tokenów, tryb non-thinking, temperatura 0 i seed 42. W podstawowym porównaniu 4B przez llama_cpp okno miało 512 tokenów, a qairt korzystał z konfiguracji paczki. Osobne serie długości wejścia mają stałe okno 16 384 tokenów.
Każda próba jest pierwszym żądaniem w nowym procesie. Próba rozgrzewkowa może rozgrzać system i cache plików, ale nie instancję runtime’u kolejnej próby. Raportowane czasy generacji nie obejmują ładowania modelu. Ten sam tekst promptu ma 48 tokenów wejścia w llama_cpp i 61 w qairt. Obie ścieżki używają różnych artefaktów i konfiguracji, więc porównanie TTFT nie izoluje wpływu sprzętu.
Stany zasilania ustawiałem ręcznie: zasilacz, bateria oraz bateria z Power Saving.
4. Wyniki: szybkość, energia i długość wejścia
Wykresy pokazują wyniki zapisanych prób. Kreski na wykresach szybkości oznaczają minimum i maksimum, nie przedział ufności. AC oznacza zasilacz, a Power Saving to tryb oszczędzania energii.
4.1 Szybkość: 4B i trzy stany zasilania
Mediana z 5 prób po 1 próbie wprowadzającej. Wyjątek to CPU z Power Saving, gdzie próba wprowadzająca przekroczyła limit czasu. Limit odpowiedzi to 128 tokenów, bez trybu thinking. Dla llama_cpp okno ma 512 tokenów, a dla qairt wynika z paczki.
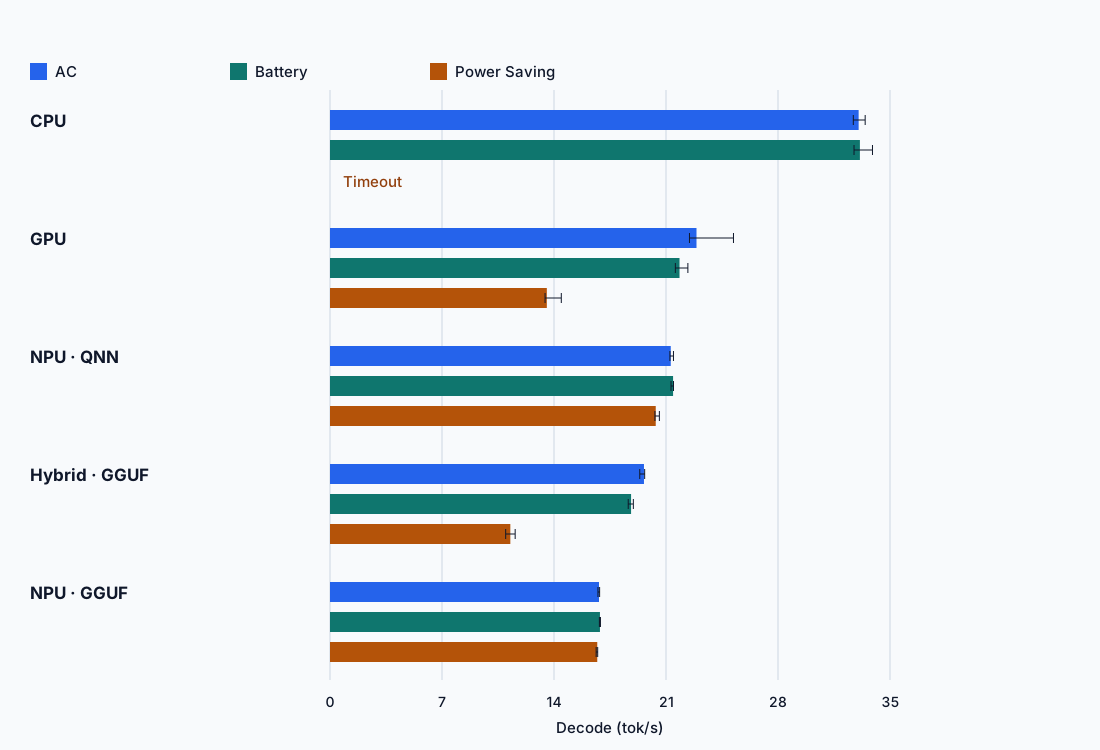
| Ścieżka | decode AC (tok/s) | decode bateria (tok/s) | decode bateria + Power Saving (tok/s) |
|---|---|---|---|
| llama_cpp CPU | 33,0 | 33,1 | ⏱ timeout |
| llama_cpp GPU (Adreno) | 22,9 | 21,8 | 13,6 |
| GenieX qairt (QNN → NPU) | 21,3 | 21,4 | 20,4 |
| llama_cpp hybrid | 19,6 | 18,8 | 11,3 |
| llama_cpp NPU (ggml-hexagon) | 16,8 | 16,9 | 16,7 |
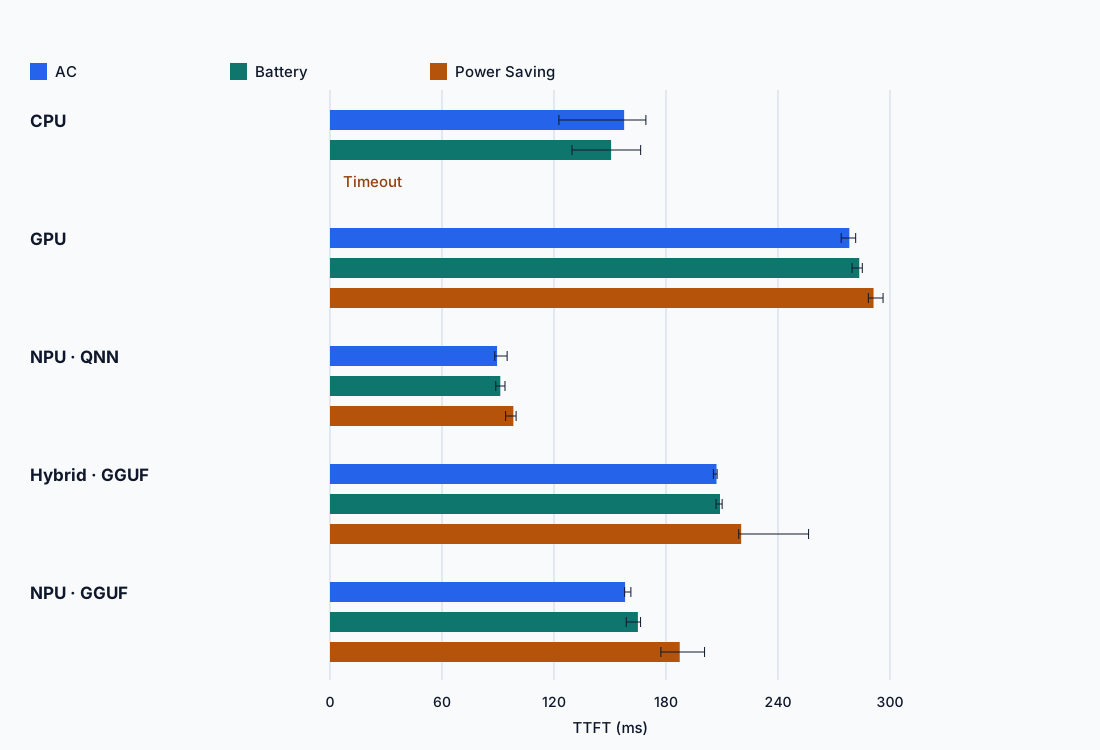
qairt miał najkrótszy TTFT: mediany 89–98 ms zależnie od stanu zasilania. CPU osiągnął 150–158 ms, NPU przez ggml-hexagon 158–187 ms, hybrid 207–220 ms, a GPU 278–291 ms. To wyniki całych ścieżek, nie samych urządzeń: qairt przetwarzał 61 tokenów wejścia, a llama_cpp 48.
4.2 Średnia moc: ile watów pokazał pomiar?
Żeby porównanie było czytelniejsze, pokazuję średnią moc netto w watach (W). Waty mówią, jak szybko zużywana jest energia, a nie ile zużyto jej na całą odpowiedź. Niższa moc nie zawsze oznacza mniejszą energię zadania, jeśli model musi pracować znacznie dłużej.
To przybliżenia kanału SYS po odjęciu osobno zmierzonego spoczynku, nie całkowity pobór laptopa z gniazdka ani pomiar samego NPU. Średnią obliczyłem z odczytanej energii i czasu uruchomienia, razem z ładowaniem modelu. Historyczne odczyty obu serii wymagały różnego przeliczenia jednostek. Dokładny zakres licznika i błąd pomiaru nie są ustalone.
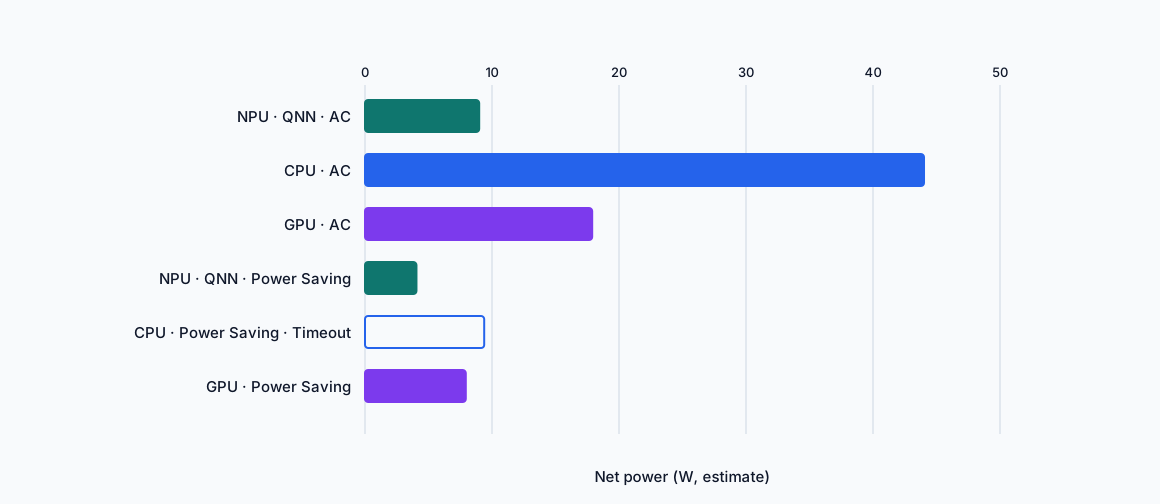
| Konfiguracja | Średnia moc netto SYS, W ≈ | Czas uruchomienia, s | Tokeny odpowiedzi |
|---|---|---|---|
| qairt, zasilacz | 9,0 | 96 | 1563 |
| CPU, zasilacz | 44,0 | 62 | 1448 |
| GPU, zasilacz | 17,9 | 96 | 2048 |
| qairt, bateria + Power Saving | 4,1 | 117 | 1563 |
| GPU, bateria + Power Saving | 7,9 | 201 | 2048 |
| CPU, bateria + Power Saving, timeout | 9,4 | 1802 | Brak ukończonego wyniku |
Najprościej: w osobnej próbie na zasilaczu odczyt wynosił około 44 W dla CPU, 18 W dla GPU i 9 W dla qairt na NPU. Na baterii z Power Saving qairt pokazał około 4 W, a GPU około 8 W. To obiecujący kierunek dla NPU, nie prognoza czasu pracy baterii.
Każda konfiguracja ma tylko jedną próbę, a odpowiedzi różnią się długością i treścią. Dlatego nie traktuję tych liczb jako porównania kosztu jednakowego zadania. Wynik CPU z timeoutem jest osobną obserwacją, nie ukończonym testem. Seria baterii zmienia jednocześnie źródło zasilania i tryb pracy, więc nie izoluje wpływu samego Power Saving.
4.3 Wnioski: co wybrać na baterii i z Power Saving?
Samo odłączenie zasilacza nie zmieniło mocno szybkości w tym krótkim teście: decode różnił się o mniej niż 1% dla CPU i obu ścieżek NPU, o około 4,6% dla GPU i 4,1% dla hybrid.
W tym teście z Power Saving wybrałbym NPU ze względu na szybkość generowania. qairt utrzymał około 20,4 tok/s, a ggml-hexagon 16,7 tok/s. GPU spadło do 13,6 tok/s, hybrid do 11,3 tok/s, a CPU nie ukończył próby wprowadzającej w limicie 15 minut. Podczas tej próby obserwowałem pracę 8 z 12 wątków, ale nie ustaliłem przyczyny opóźnienia.
NPU miało więc najwyższe tempo decode spośród badanych konfiguracji w tym trybie, choć nie było jedynym działającym wyborem: GPU nadal generowało tekst. Niższy przybliżony odczyt mocy qairt w osobnej, pojedynczej próbie jest obiecującą obserwacją, ale nie dowodem mniejszej energii jednakowego zadania ani dłuższej pracy na baterii. Rekomendację opieram przede wszystkim na utrzymanej szybkości w Power Saving.
4.4 Kwantyzacja: 4B na CPU i NPU przez ggml-hexagon
Zasilacz, krótki prompt, mediana z 5 prób. Na wykresie decode, czyli tempo generowania kolejnych tokenów.
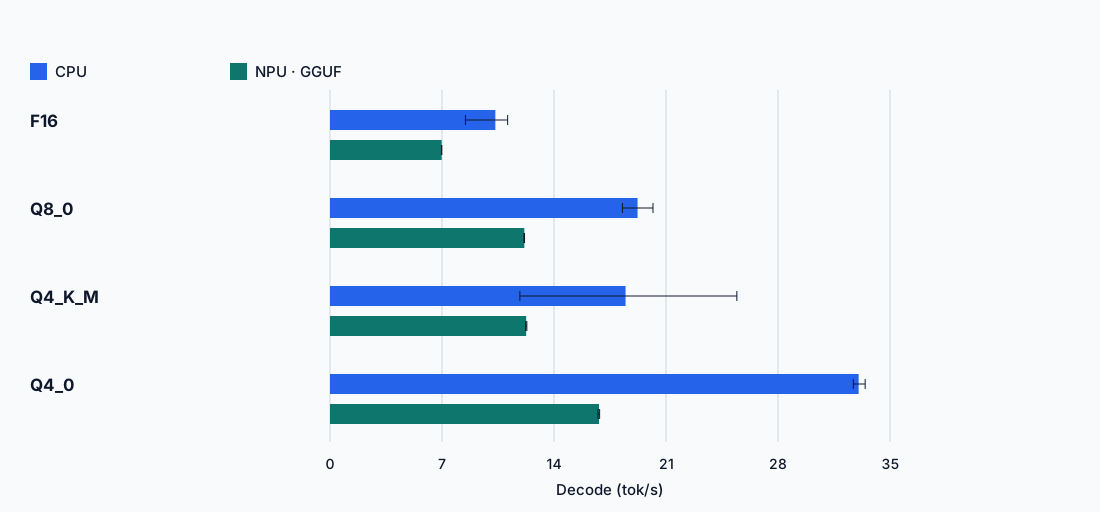
| Kwantyzacja | CPU | NPU (ggml-hexagon) |
|---|---|---|
| F16 | 10,3 | 7,0 |
| Q8_0 | 19,2 | 12,1 |
| Q4_K_M | 18,5 | 12,3 |
| Q4_0 | 33,0 | 16,8 |
Osobna paczka qairt QNN W4A16 osiągnęła 21,3 tok/s. Nie umieszczam jej w tej samej serii kwantyzacji GGUF.
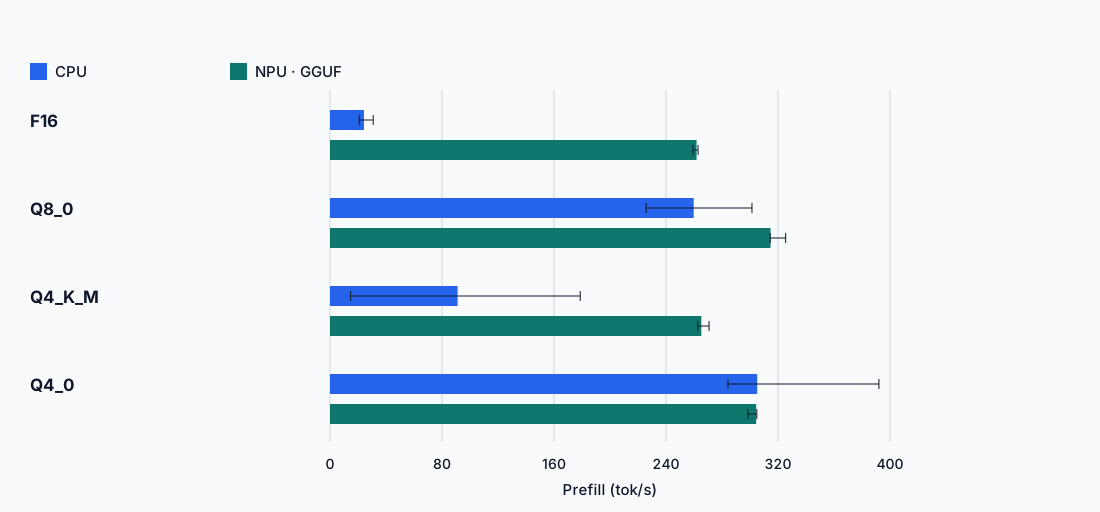
Q4_0 był na CPU około 3,2 razy szybszy niż F16 w decode i ponad 12 razy w prefillu. NPU miało wolniejszy decode dla wszystkich tych GGUF, ale mniejsze różnice prefillu między kwantyzacjami. To wynik tego modelu i buildu, nie ogólna hierarchia schematów. W tej serii mierzyłem szybkość, nie jakość odpowiedzi.
4.5 Liczba parametrów: od 1.7B do 32B na CPU
Zasilacz, Q4_K_M, non-thinking, po 5 mierzonych prób.
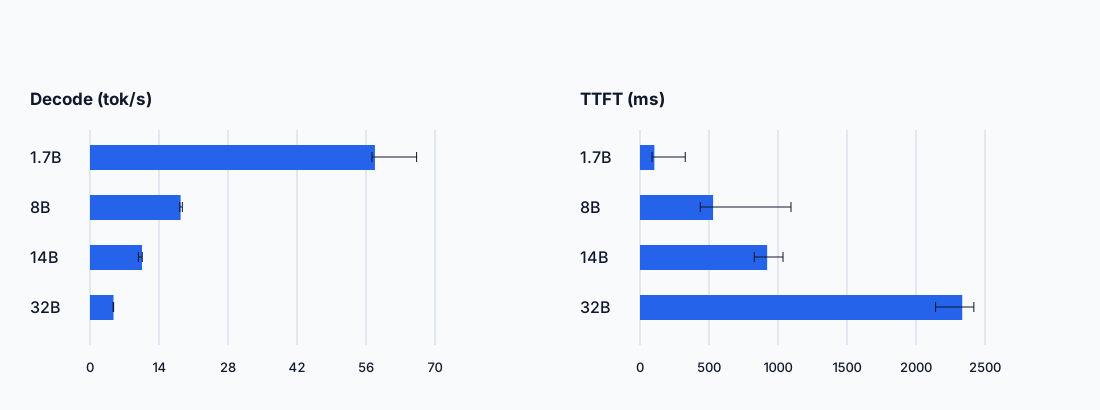
| Liczba parametrów | decode (tok/s) | prefill (tok/s) | TTFT (ms) |
|---|---|---|---|
| 1.7B | 57,8 | 500,4 | 104 |
| 8B | 18,4 | 98,3 | 530 |
| 14B | 10,5 | 56,5 | 921 |
| 32B | 4,8 | 22,3 | 2335 |
-
To oryginalny Qwen3 z przełączanym thinking/non-thinking, tutaj z wyłączonym thinking. 4B-2507 to inny checkpoint, więc nie wchodzi wprost w tę serię. Co z tego jest praktyczne?
-
1.7B: największy zapas szybkości. Warto zacząć od niego przy prostych, wąskich zadaniach, ale sprawdzić, czy jakość wystarcza.
-
8B: około 18 tok/s przy krótkim wejściu to rozsądny punkt startowy do interaktywnej pracy.
-
14B: około 10,5 tok/s, czyli wolniejsza, ale nadal sensowna opcja, jeśli większy model daje lepszy wynik w konkretnym zadaniu.
-
32B: około 4,8 tok/s. Sam decode 128 tokenów zajmuje orientacyjnie 27 s. W tym teście było to dla mnie zbyt wolne do wygodnego, interaktywnego czatu. Nie wyklucza to zastosowań wsadowych, jeśli dłuższe oczekiwanie jest akceptowalne, a jakość odpowiedzi uzasadnia wybór większego modelu; tego tutaj nie oceniałem.
32B jest największym modelem, dla którego uzyskałem wynik w tej serii, nie ustalonym limitem tego laptopa. Te próby mają krótkie wejście i okno 512 tokenów. Szybkość nie dowodzi jakości, a dłuższy dokument może znacznie zmienić responsywność.
4.6 Pojemność okna i rzeczywista długość wejścia
Zmiana pojemności okna przy krótkim prompcie (CPU, AC)
Zmieniałem pojemność okna, zostawiając 52 tokeny wejścia i 128 tokenów odpowiedzi. Historia rosła więc do około 180 pozycji, nie do 65k czy 262k. Poniżej mediany TTFT z trzech prób na komórkę.
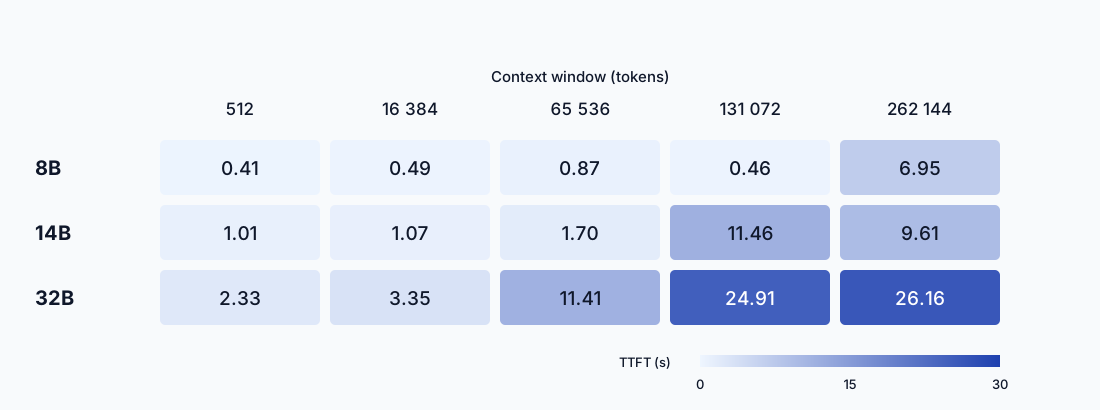
| Liczba parametrów | 512 | 16 384 | 65 536 | 131 072 | 262 144 |
|---|---|---|---|---|---|
| 8B | 0,41 s | 0,49 s | 0,87 s | 0,46 s | 6,95 s |
| 14B | 1,01 s | 1,07 s | 1,70 s | 11,46 s | 9,61 s |
| 32B | 2,33 s | 3,35 s | 11,41 s | 24,91 s | 26,16 s |
Przy większych limitach TTFT wzrastał, ale nie monotonicznie. Nie ustaliłem przyczyny ani praktycznego limitu długości dokumentu: ten test nie zapełniał okna.
Dłuższe wejście przy stałym oknie (4B Q4_0, CPU i NPU)
Na zasilaczu, z profilem maksymalnej wydajności, zostawiłem okno 16 384 tokenów i zwiększałem długość syntetycznego wejścia z powtarzanych akapitów. Najpierw wykonałem serię CPU, potem NPU przez GenieX llama_cpp, czyli ggml-hexagon, nie qairt. Użyłem tego samego zarejestrowanego Qwen3-4B-Instruct-2507 Q4_0, identycznych promptów, temperatury 0 i trzech mierzonych prób na komórkę, po jednej próbie wprowadzającej. Każda próba to nowy proces, a każda odpowiedź miała dokładnie 128 raportowanych tokenów i kończyła się limitem długości.
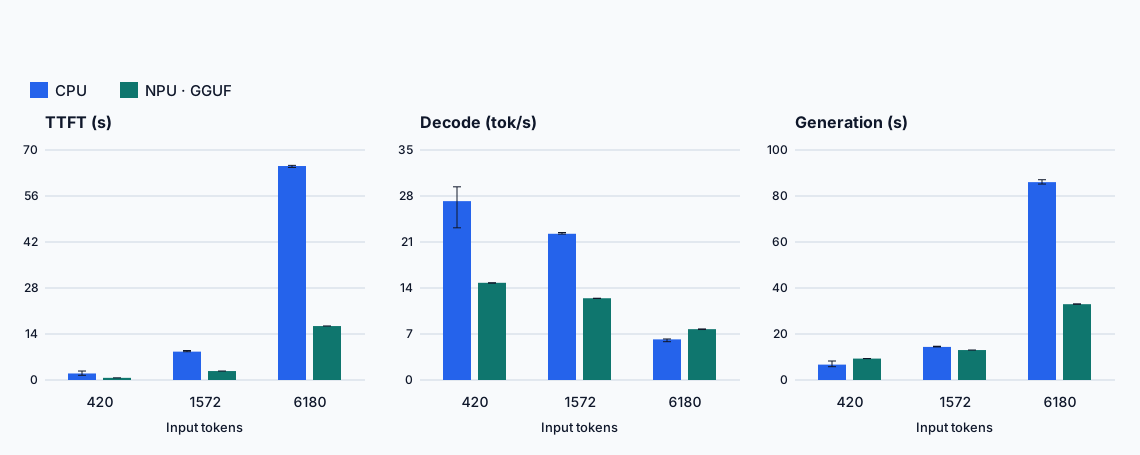
| Tokeny wejścia | TTFT CPU | TTFT NPU | Decode CPU, tok/s | Decode NPU, tok/s | Cała generacja CPU | Cała generacja NPU |
|---|---|---|---|---|---|---|
| 420 | 1,99 s | 0,66 s | 27,22 | 14,79 | 6,69 s | 9,31 s |
| 1572 | 8,63 s | 2,72 s | 22,25 | 12,44 | 14,38 s | 13,02 s |
| 6180 | 65,12 s | 16,42 s | 6,18 | 7,74 | 86,03 s | 32,96 s |
Cała generacja to mediana całkowitego czasu generacji raportowanego przez silnik, bez ładowania modelu, nie suma median innych metryk. Prefill CPU wyniósł odpowiednio 211,2, 182,1 i 94,9 tok/s, a NPU 640,9, 577,1 i 376,4 tok/s.
Przy dłuższym wejściu NPU może być szybsze od CPU. Dla 6180 tokenów wejścia i 128 tokenów odpowiedzi generacja trwała około 33 s na NPU wobec 86 s na CPU. Przy najkrótszym wejściu wcześniej kończył CPU. Wybór zależy więc również od długości wejścia i odpowiedzi.
To dwa osobne wyniki: przewagę szybkości dłuższego wejścia zmierzyłem przez ggml-hexagon, a niższą moc w innej serii przez qairt. Nie zmierzyłem mocy ani energii tego testu dłuższego wejścia.
Pomiędzy krańcami decode CPU spadł o około 77%, a NPU o 48%. Nie przypisuję spadku jednemu mechanizmowi: wejście jest syntetyczne, serie szły od najkrótszej, bez rejestracji temperatury i taktowania. Nie zmierzyłem tu energii ani jakości pracy z dokumentami.
5. Co wybrać do konkretnego zastosowania
5.1 Praktyczne wnioski na podstawie tych prób
Nie wybierałbym jednej konfiguracji do wszystkiego. Najpierw ustaliłbym, czy ważniejsze są szybkość odpowiedzi, praca na baterii, długość dokumentu czy możliwości większego modelu. Poniższe propozycje są punktem startowym do własnych zadań, nie rankingiem jakości modeli ani gwarancją zachowania każdej aplikacji.
| Potrzebujesz | Punkt wyjścia | Co potwierdzają próby |
|---|---|---|
| Szybkie generowanie przy krótkim wejściu na zasilaczu | 4B Q4_0 przez GenieX llama_cpp na CPU |
Około 33 tok/s. W osobnej próbie CPU miał wyższą średnią moc netto niż qairt |
| Responsywne generowanie na baterii z Power Saving | NPU: GenieX qairt, alternatywnie llama_cpp |
Odpowiednio 20,4 i 16,7 tok/s. Około 4 W netto SYS dla qairt to osobna, pojedyncza obserwacja, nie pomiar czasu pracy na baterii |
| Większy model do interaktywnej pracy | Zacznij od 8B lub 14B Q4_K_M na CPU | Około 18,4 i 10,5 tok/s przy krótkim wejściu. Jakość trzeba ocenić na własnym zadaniu |
| Dłuższe wejście i krótka odpowiedź | llama_cpp na NPU |
Przy 6180 tokenach wejścia i 128 wyjścia około 33 s generacji wobec 86 s na CPU |
5.2 Moje podsumowanie
NPU okazało się użyteczne i będę sprawdzał je dalej. Nie jest jednak automatycznie najlepsze tylko dlatego, że zostało zaprojektowane do obliczeń sieci neuronowych:
- Krótkie wejście i zasilacz: CPU z Q4_0 dawało najwyższe tempo decode badanego 4B. Do szybkiej odpowiedzi nie muszę na siłę używać NPU.
- Power Saving: NPU zachowało responsywność lepiej niż GPU i hybrid. Dlatego qairt jest dla mnie pierwszym kandydatem do generowania w tym trybie. Niższy przybliżony odczyt SYS w osobnej próbie jest dodatkową obserwacją, nie potwierdzeniem dłuższej pracy na baterii.
- Dłuższe wejście: ggml-hexagon potrafił wygrać z CPU czasem całej odpowiedzi. Benchmark krótkiego pytania nie wystarcza do wyboru konfiguracji dla dokumentów.
- Wielkość modelu: 8B i 14B wyglądają rozsądnie pod względem szybkości. 32B (około 4,8 tok/s) było dla mnie zbyt wolne do wygodnego czatu, ale może być przydatne w zadaniach wsadowych. Więcej parametrów ma sens tylko wtedy, gdy poprawia wynik konkretnego zadania; jakość trzeba sprawdzić osobno.
Następny krok to sprawdzić, czy wybrane modele rzeczywiście radzą sobie z realnymi zadaniami: poprawianiem tekstu, streszczaniem notatek, wydobywaniem informacji z dokumentów albo pomocą przy kodzie.
Chcę też sprawdzić, jak przełożyć działające konfiguracje na codzienne użycie, np. w LM Studio, Ollamie lub AnythingLLM.
LLM nie wyczerpuje też możliwych zastosowań NPU. Transkrypcja nagrań czy przetwarzanie obrazu to kolejne kierunki do sprawdzenia, z innymi modelami i wymaganiami.