Lokalny agent Home Assistant na Arduino VENTUNO Q
1. Od benchmarku do asystenta
W poprzednim eksperymencie z Bielikiem sprawdzałem, jak duży model można uruchomić na Arduino VENTUNO Q. Tym razem chciałem zrobić z płytki coś użytkowego: lokalnego asystenta głosowego dla Home Assistant, z którym można rozmawiać po polsku.
Założenie było proste: modele rozpoznające mowę, przygotowujące odpowiedź i generujące głos mają pracować na płytce, bez chmurowych API inferencji. Nie chodziło o przeniesienie całego Home Assistant na Arduino. HA nadal zarządza domem, a VENTUNO Q udostępnia mu lokalne usługi AI.
TL:DR
Ostatecznie na płytce działają trzy sieci: Whisper Large-v3-Turbo, Qwen2.5-3B i polski Pocket TTS. Dwie pierwsze korzystają z NPU, ostatnia z CPU. Linux Voice Assistant (LVA) obsługuje lokalne wybudzanie „Okay Nabu”. Mikrofon i głośnik to jeden głośnik konferencyjny USB. Największym wyzwaniem był dobór wydajnych, w pełni kompatybilnych elementów toru głosowego oraz zintegrowanie ich w działający system.
Kod i instalacja: github.com/p4vv37/ha-local-agent - bramka, router i przepis uruchomienia całego zestawu na Arduino.
2. Trzy sieci, jedna płytka, Home Assistant pomiędzy nimi
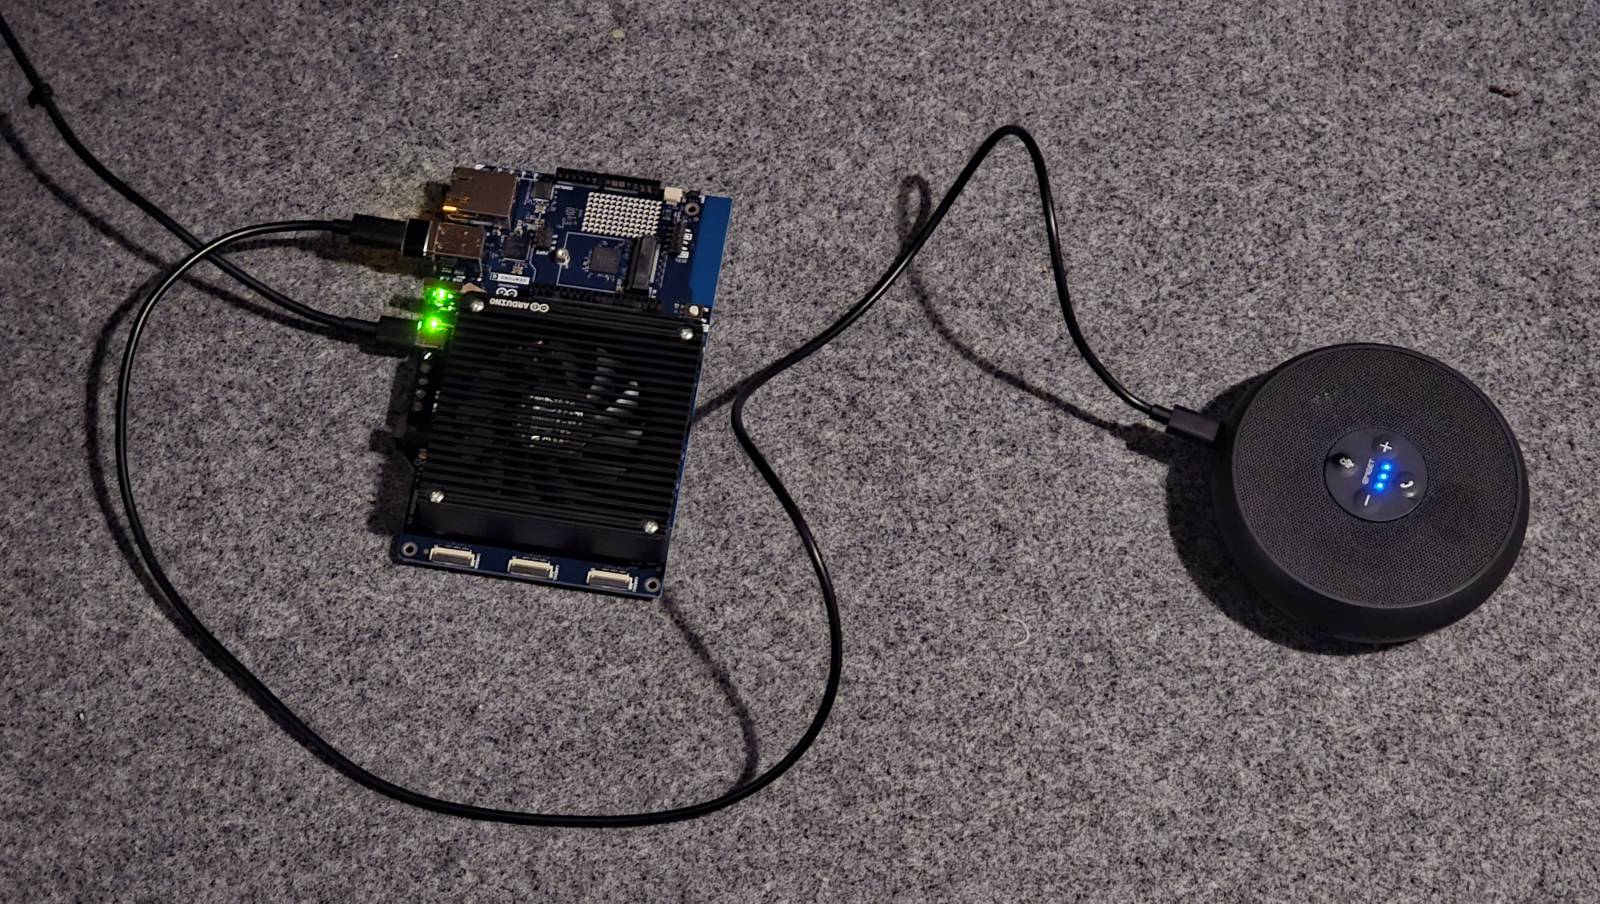
VENTUNO Q ma układ Qualcomm Dragonwing IQ-8275, 16 GB RAM i akcelerator Hexagon. W tym projekcie dzieli pracę następująco:
| Etap | Aktywny model i zadanie | Gdzie mają miejsce obliczenia |
|---|---|---|
| STT - mowa na tekst | Whisper Large-v3-Turbo W8A16: rozpoznanie polskiej mowy | Encoder i decoder na NPU, przygotowanie audio i sterowanie dekodowaniem na CPU |
| LLM - decyzja i odpowiedź | Qwen2.5-3B-Instruct Q4_0: tekst oraz wywołania narzędzi | NPU, przez GenieX |
| TTS - tekst na mowę | Pocket TTS Polish, checkpoint 6L i referencyjny głos autora | CPU, oficjalny runtime Rust ARM64, model utrzymywany w pamięci |
Mikrofon, wybudzanie i odtwarzanie obsługuje Linux Voice Assistant (LVA) projektu OHF-Voice, uruchomiony na tej samej płytce. Korzysta z frazy „Okay Nabu” i głośnika konferencyjnego USB EMEET OfficeCore M1A. LVA przekazuje nagranie do HA i odtwarza zwrócone audio. Rozpoznawanie mowy i synteza są osobnymi usługami.
Home Assistant wybiera kolejne etapy: wysyła nagranie do STT, tekst do agenta, wykonuje dostępne narzędzia, a odpowiedź kieruje do TTS.
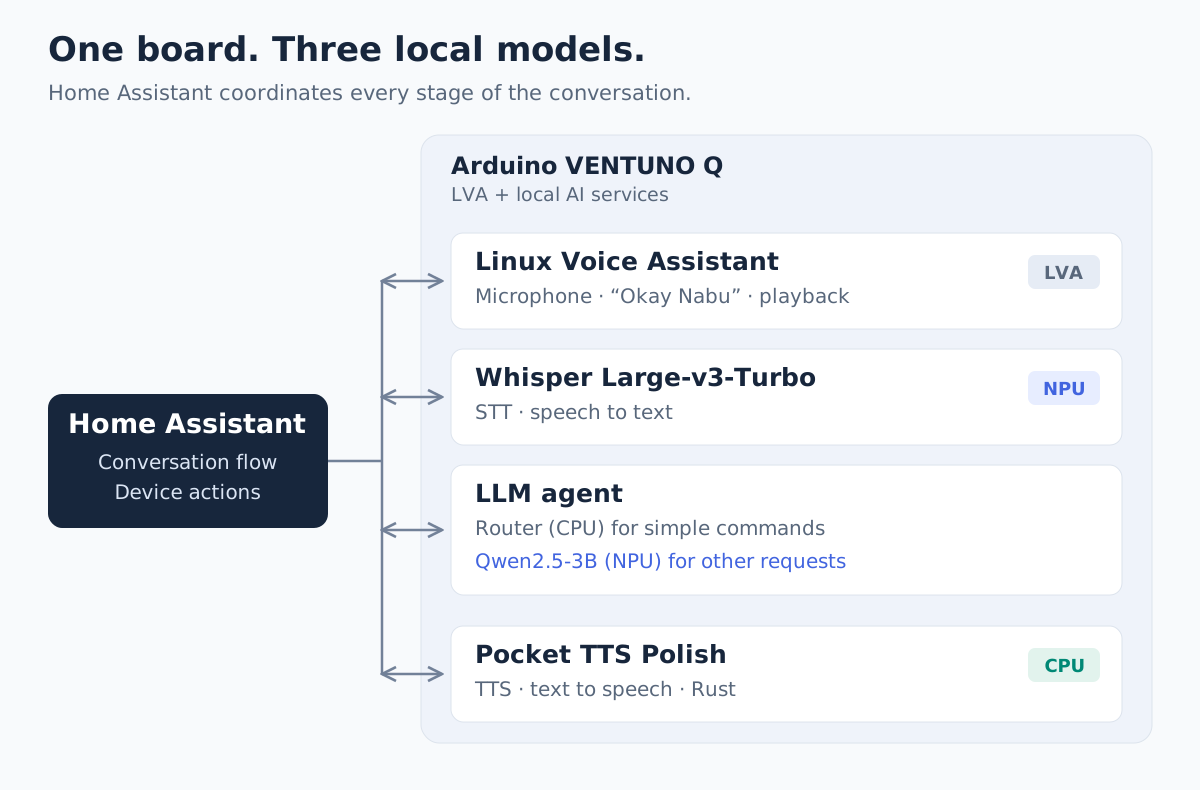
Wszystkie trzy modele są lokalne, ale „na płytce” nie znaczy „wszystko na NPU”. Sama bramka LLM nie steruje urządzeniami - zwraca wywołanie funkcji, które obsługuje HA.
3. STT: od CPU do Large-v3-Turbo na NPU
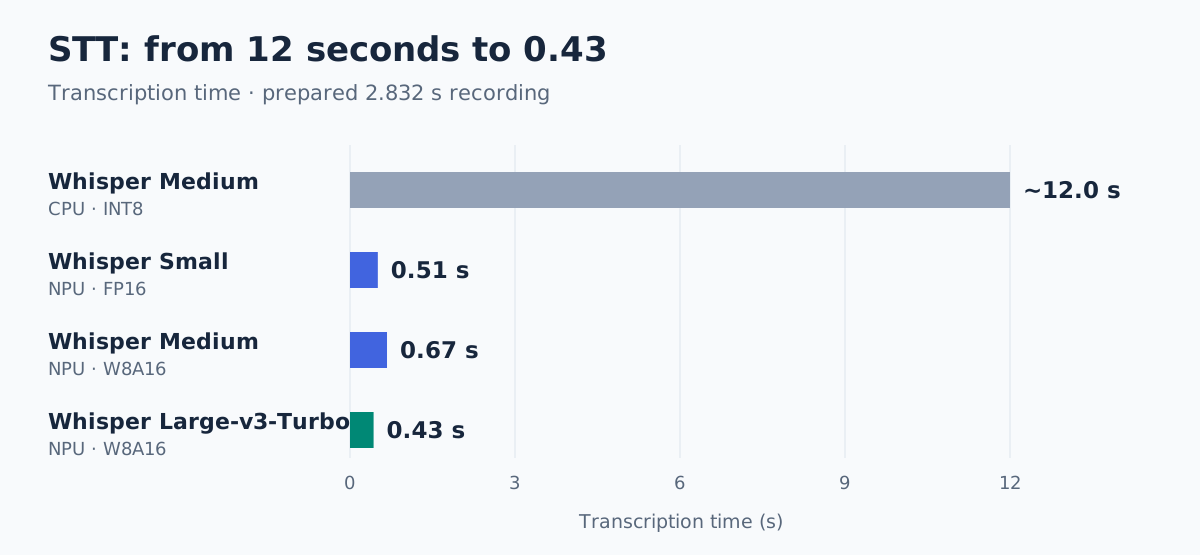
Zacząłem od Whisper Medium INT8 na CPU. Dla krótkiej próbki potrzebował około 12 sekund. Small i Base były szybsze, lecz w niewielkich próbach pojawiały się błędy w nazwach i łączeniu słów. W asystencie domowym poprawna transkrypcja ogólnego sensu nie zawsze wystarcza do wyboru właściwego urządzenia.
Następnie uruchomiłem Medium W8A16 na NPU i uzyskałem 0,67 s. Ostatecznie wybrałem Whisper Large-v3-Turbo W8A16 z oficjalnego pakietu Qualcomm dla QCS8275, z tokenizerem OpenAI. Ten wariant transkrybuje przygotowane nagranie o długości 2,832 s w około 0,43 s, czyli około 28 razy szybciej od wyjściowego Medium na CPU. Porównuję tu kolejne konfiguracje, różniące się też modelem i precyzją. Wydzielony ONNX Runtime korzysta z QNN Execution Provider. Encoder i decoder mają wyłączony fallback na CPU.
4. LLM: dlaczego skończyłem na Qwen 2.5 3B
Model miał rozumieć polski, obsługiwać tool calling i pozostawić zasoby dla pozostałych usług. Wcześniejsze próby z wariantem 11B nie dały mi konfiguracji odpowiedniej do tego zastosowania, dlatego tym razem szukałem mniejszego modelu.
Sprawdziłem Qwen3-1.7B, Qwen3-4B oraz Qwen2.5-3B. W kontrolowanej serii trzech prób 1.7B raz wywołał narzędzie zamiast zwrócić zadane zdanie. Qwen2.5-3B zachował wymaganą formę we wszystkich trzech próbach.
Qwen3-4B-Instruct-2507 w wariancie QAIRT/QNN działał z krótkim wejściem, ale pełny opis HA nie mieścił się w skonfigurowanym oknie kontekstu. Z kolei Qwen3-4B GGUF zakończył próbę ładowania błędem mapowania pamięci FastRPC. To dwa różne warianty modelu i dwa różne problemy. Ostatecznie wybrałem Qwen2.5-3B jako kompromis jakości i wykonalności.
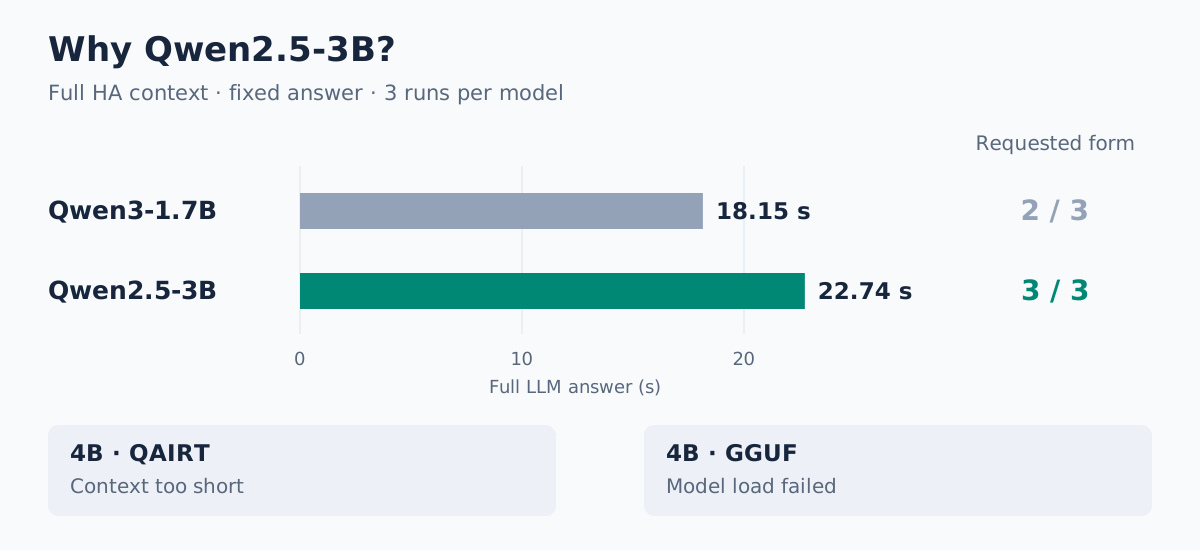
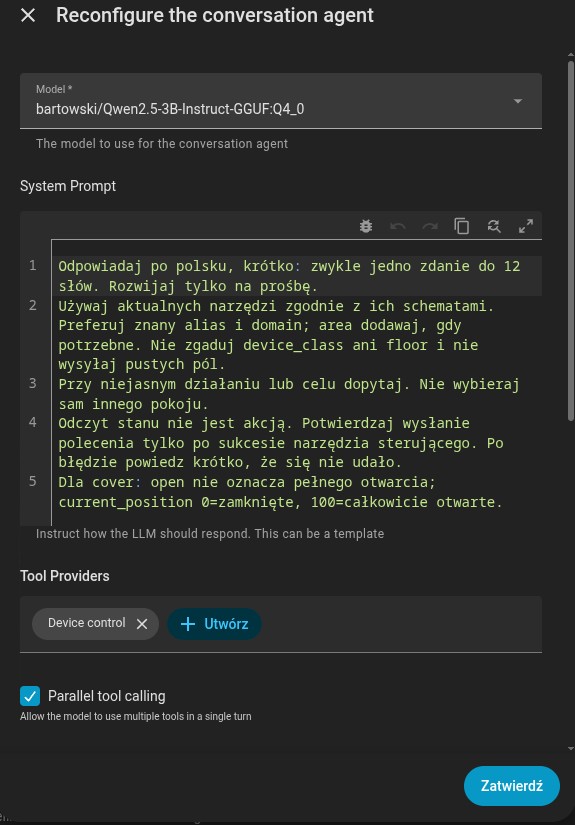
Wybrałem Qwen2.5-3B-Instruct GGUF Q4_0, uruchamiany przez GenieX i backend Hexagon.
Kontekst od HA
Jak wspomniałem podczas opisywania problemów z rozmiarem modelu: nawet krótka wypowiedź użytkownika nie oznacza krótkiego żądania do modelu. Dochodzą instrukcje, historia i definicje narzędzi. W celu zmniejszenia ilości tych danych i przyspieszenia działania asystenta zastosowałem ograniczenie ekspozycji urządzeń. To działanie zmniejszyło wejście z 7781 do 3550 tokenów.
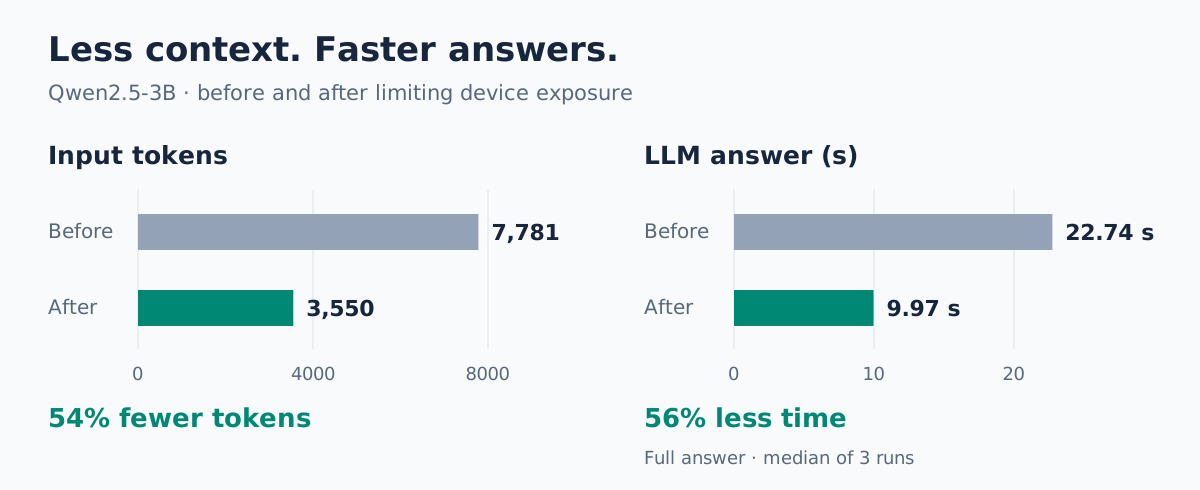
W kontrolowanym zadaniu zwracania stałego zdania mediana z trzech prób spadła z 22,74 do 9,97 s, czyli o 56%. To czas kompletnej odpowiedzi LLM. Dla porównania: bez kontekstu HA podobne zdanie zajmowało około 1,8 s.
Nie każde żądanie musi jednak uruchamiać LLM. W aktywnej bramce działa też wąski, deterministyczny router przed modelem: dla części jednoznacznych poleceń potrafi przygotować tool_calls, które nadal wykonuje HA. Korzysta z bieżącego schematu narzędzi i katalogu wyprowadzonego z kontekstu, nie z przypiętej listy domowych urządzeń, dostosowuje się więc dynamicznie do ustawień HA.
Po co własny router, skoro HA ma lokalne intencje?
Home Assistant potrafi obsługiwać proste polecenia bez LLM i korzystam z tej możliwości. Przy włączonej opcji preferowania lokalnych intencji najpierw próbuje rozpoznać polecenie własnym mechanizmem. Jeśli mu się uda, bramka i Qwen nie są potrzebne.
Własny router dodałem dla komend, które przechodzą do agenta, choć nadal są proste. Powodem może być drobny błąd transkrypcji, np. „relety” zamiast „rolety”. Nie chcę wtedy od razu uruchamiać LLM, jeśli nazwę urządzenia i pomieszczenie można jednoznacznie dopasować do katalogu HA. Router uwzględnia odmianę polskich nazw i toleruje jedną edycję. Przy kilku pasujących celach prosi o doprecyzowanie.
To dodatkowa warstwa między lokalnymi intencjami HA a Qwenem. HA obsługuje to, co już rozpoznaje, router przejmuje wąską klasę pozostałych komend, a model dostaje wypowiedzi wymagające szerszej interpretacji.
Router: dopasowanie z tolerancją na błędy
Router to Python przetwarzany na CPU, nie kolejny model. Proces jego działania podzielony jest na 5 kroków:
- Normalizacja komendy: wielkość liter, polskie znaki, nadmiarowe spacje.
- Lematyzacja (za pomocą modułu
simplemma): formy odmiany sprowadzane do podstawy -rolety→roleta,salonie→salon. Dzięki temu dopasowuje się liczba mnoga i miejscownik. - Wyciąganie aliasów urządzeń z kontekstu: rozdzielane po przecinku lub po podwójnej spacji. Realny opis encji potrafi łączyć nazwy bez przecinka (
„roleta Rolety"). - Dopasowanie nazwy i obszaru: najpierw dokładne, potem z tolerancją jednej edycji (odległość Levenshteina). To dopełnienie błędów STT -
uroletyireletytrafiają wrolety,sypialiwsypialni. - Decyzja:
TOOLCALLtylko przy jednym pasującym celu i jednym obszarze. Zero lub kilka trafień →CLARIFY(doprecyzowanie), nigdy zgadywanie. Wypowiedź poza zakresem →PASSdo Qwena. Po wyniku narzędzia router zwraca krótkieACK(„Wykonano”/„Nie udało się.“), zamiast kolejnej rundy LLM.
Zmierzony czas decyzji routera to około 2 ms (bez inferencji), wobec około 10 s pełnej rundy LLM. To czas decyzji, nie fizycznego zamknięcia rolety ani potwierdzenia stanu przez HA.
5. TTS
Do syntezy mowy wykorzystuję Pocket TTS Polish - shefowl/pocket-tts-polish-6l, z polskim głosem referencyjnym autora. Checkpoint i referencja pozostały te same, obliczenia nadal wykonuje CPU. Zmieniłem runtime i sposób dostarczania audio, nie model na inny głos ani na rozwiązanie NPU.
Początkowo korzystałem ze ścieżki Python/PyTorch. Wygenerowanie 2 s dźwięku zajmowało około 7,3 s, a 7 s dźwięku około 20,6 s.
Obecnie adapter uruchamia rozgrzany proces z Pocket TTS dla ARM64. Korzystam z oficjalnego wydania v4.0.1 projektu Kyutai.
Serwer TTS nadal wystawia Wyoming. Przed wysyłką zbiera 2 s audio i mierzy RTF (czas generacji podzielony przez długość audio): jeśli silnik generuje wolniej, niż trwa mowa (RTF > 0,9), buforuje całość i wysyła na końcu - bez ponownego generowania tej samej wypowiedzi.
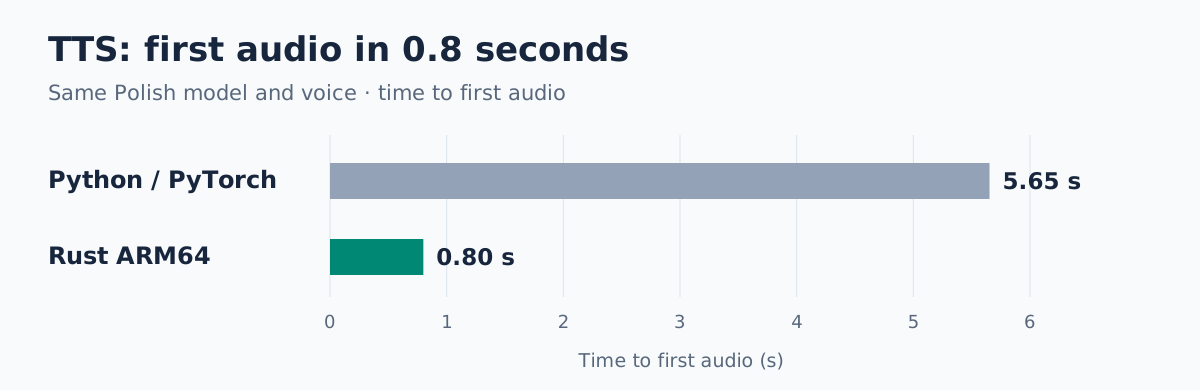
Oczekiwanie na pierwsze próbki dźwięku skróciło się z 5,65 s do około 0,8 s. To inna miara niż czas wygenerowania całej wypowiedzi podany wyżej.
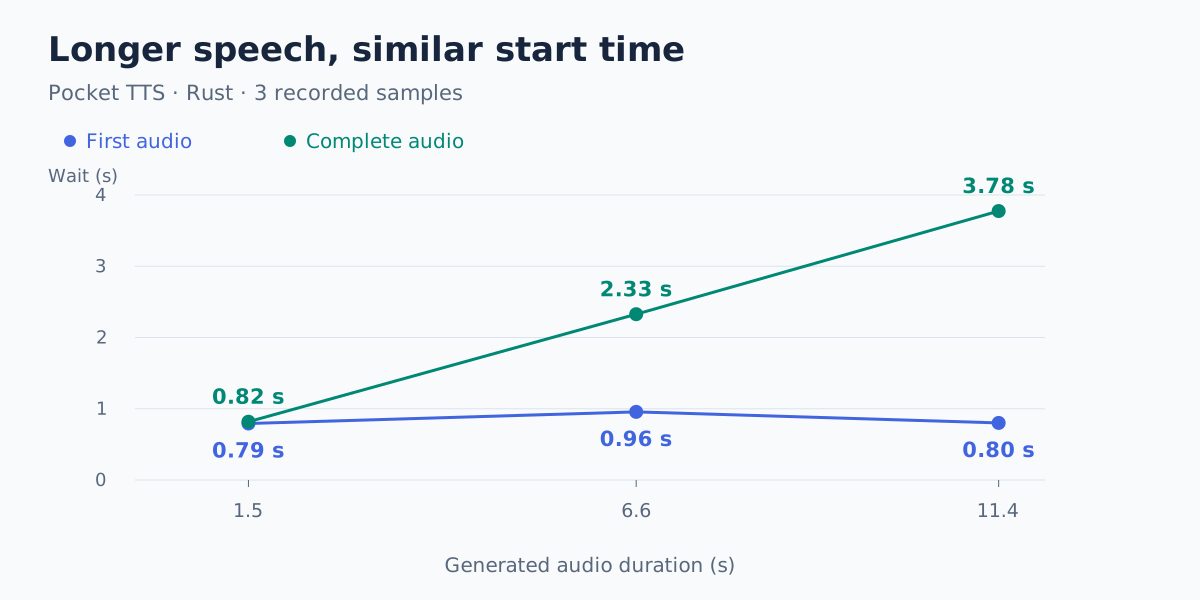
Pomiar u klienta Wyoming, przy rozgrzanym procesie Rust. W tych trzech próbach początek audio był dostępny po 0,79-0,96 s, a czas dostarczenia całości rósł z długością wypowiedzi.
6. Połączenie z HA i start usług
HA łączy się ze STT przez Wyoming na porcie 10301, bramką agenta na 18191 i TTS przez Wyoming na 10201. Porty można zmienić, jeśli adresy w HA i usługach będą zgodne.
Pełny przepis uruchomienia zestawu znajduje się w README repozytorium ha-local-agent. Obejmuje przygotowanie GenieX i Qwena, bramki z routerem, Whispera na NPU, polskiego Pocket TTS oraz satelity LVA. Kod wrappera i instrukcje przygotowania pozostałych komponentów są w jednym miejscu.
Integracja: Local OpenAI LLM
Wybrałem integrację społecznościową Local OpenAI LLM, w wersji 1.15.1. Pozwala wskazać własny Server URL zgodny z OpenAI, więc może połączyć HA z GenieX. Oficjalna integracja OpenAI obsługuje usługę OpenAI, a integracja Ollama wymaga serwera Ollama. Dla użytej bramki ustawiam:
- Server URL (OpenAI-compatible):
http://<adres-Arduino>:18191/v1, - typ serwera
llama.cppz opcjami samplingu, tool calling włączony po stronie silnika.
Integracja to cienka warstwa: przekazuje schematy narzędzi HA jako tools, a wyniki wywołań jako role: tool w kolejnej iteracji (pętla do 10 iteracji). Sterowanie nadal wykonuje HA - ani bramka, ani integracja nie ruszają urządzeń same.
Bramka serializuje żądania, obsługuje różnice w streamingu i ma obejście pustej odpowiedzi przy identycznym powtórzeniu pytania.
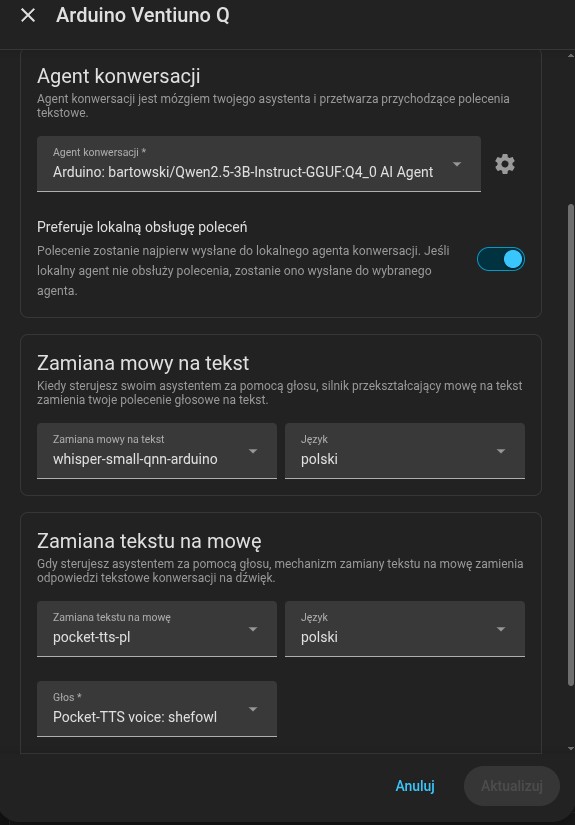
Aktualna jednostka STT i boot guard wskazują już Turbo. Pilnują kolejności oraz tego, by nie ładować równocześnie kilku wariantów STT na NPU, nie wykonują automatycznego fallbacku na CPU. TTS ma politykę automatycznego startu unless-stopped. Po najnowszych zmianach Turbo i Rust nie przeprowadziłem pełnego rebootu płytki. Zmiana konfiguracji autostartu i pomyślne testy usług nie zastępują takiego sprawdzianu.
7. Rezultat
Najważniejszy rezultat jest konkretny: na małym urządzeniu działają lokalne modele mowy i języka, a Home Assistant potrafi z nich korzystać - bez chmury, bez kluczy API i bez komputera z GPU włączonego 24/7.
W liczbach:
- STT: Whisper Large-v3-Turbo na NPU transkrybuje 2,8 s mowy w 0,43 s (zamiast ~12 s na CPU).
- TTS: Pocket TTS Polish na Rust dostarcza pierwsze audio po 0,79-0,96 s w trzech zmierzonych próbach (wcześniej około 5,65 s w Pythonie).
- LLM: Qwen2.5-3B odpowiada w 1,8 s bez kontekstu HA. Ograniczenie ekspozycji skróciło pełną odpowiedź z 22,7 s do 9,97 s.
- Sterowanie: wąski router regułowy przygotowuje wywołanie narzędzia dla rozpoznanych komend w ~2 ms i toleruje drobne błędy STT. Złożone polecenia trafiają do LLM z tool calling.
Efekt użytkowy: rozpoznane proste polecenia, np. „otwórz/zamknij roletę”, omijają LLM i nie wymagają czekania na jego odpowiedź. Pozostałe wypowiedzi obsługuje lokalny Qwen. Nie potrzebuję do tego osobnego komputera z kartą GPU.
Jak to wygląda w rzeczywistych rozmowach
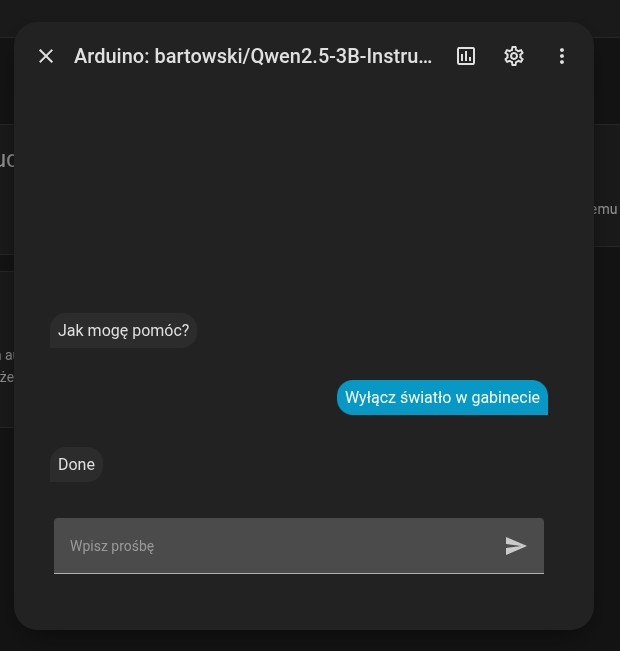
Poza benchmarkami mam też zapisy rzeczywistych poleceń z debuggera Assist. Pokazują różnicę między lokalną obsługą HA a przejściem do agenta:
| Polecenie | Ścieżka | Od końca VAD do tekstu | Etap intencji | Od końca VAD do run-end |
|---|---|---|---|---|
| Włącz światło | HA lokalnie | 0,50 s | 0,08 s | 0,58 s |
| Zamknij roletę | HA lokalnie | 0,49 s | 0,08 s | 0,58 s |
| Otwórz relety | Agent | 0,41 s | 4,94 s | 5,36 s |
| Ustaw jasność na 50% | Agent | 0,52 s | 20,11 s | 20,63 s |
| Włącz światło | HA lokalnie | 1,91 s | 0,19 s | 2,10 s |
Punktem początkowym jest zdarzenie stt-vad-end, czyli wykryty koniec mowy. Etap intencji to czas od intent-start do intent-end, obejmujący również wykonanie narzędzi i przygotowanie odpowiedzi. W poleceniu ustawienia jasności HA otrzymał poprawne wywołanie narzędzia, a po jego wyniku agent przygotował jeszcze pełne zdanie potwierdzenia. Ta druga część również kosztuje czas.
Dwa pierwsze polecenia zostały obsłużone przez lokalny mechanizm HA. Przykład z „reletami” przeszedł do agenta, który zwrócił wywołanie otwierające właściwą roletę.
Mój wkład
Wykorzystałem gotowe modele i środowiska wykonawcze, a własną pracę skupiłem na ich połączeniu. Przygotowałem bramkę między HA a GenieX, router regułowy, odczyt katalogu urządzeń z kontekstu i kontrolę budżetu wejścia. Dostosowałem też adaptery STT i TTS, obsługę strumieniowania, uruchamianie usług oraz diagnostykę i testy.
Najwięcej pracy wymagały problemy na styku tych elementów: niepoprawne argumenty narzędzi generowane przez mały LLM, długi kontekst HA, opóźniony początek syntezy i brakujące zakończenia odpowiedzi głosowych. Rezultatem jest połączenie tych komponentów w lokalny tor, w którym proste komendy mogą ominąć model, a pozostałe nadal korzystają z jego możliwości.
8. Wyzwania i problemy
Największy problem projektu jest oczywisty: 3B to za mało na skomplikowane myślenie, a jednocześnie już teraz bywa za wolno.
- Za mało na głębsze rozumowanie. Qwen2.5-3B dobrze kopiuje zdania i wybiera narzędzia w jednoznacznym kontekście, ale to nie model do wielokrokowego planowania, łączenia faktów z kilku narzędzi ani wyjaśniania zależności. Im trudniejsze polecenie, tym większe ryzyko zmyślonych argumentów.
- Za wolno na pełny kontekst. Pełny prefill z opisem encji i narzędziami to około 20 s. W rozmowie głosowej to za długo. Stąd kierunek „mniej kontekstu + router”.
- Bez ponownego użycia KV. Serwer resetuje sesję przy zmianie pytania, więc długi wspólny prefiks jest liczony od nowa przy każdym żądaniu. Użycie cache może pomóc przyspieszyć odpowiedź.
- Współdzielenie jednego NPU. Whisper (STT) i Qwen (LLM) muszą dzielić ten sam akcelerator Hexagon. Równoczesne ładowanie kilku modeli bywa niestabilne, a przy napiętej pamięci wariant 4B GGUF w ogóle się nie załadował (FastRPC ENOMEM).
Zapisy rzeczywistych rozmów pokazują już czasy STT i obsługi intencji, a także pojedynczy duży skok opóźnienia przed zakończeniem STT. Kolejny krok to wyjaśnienie tego przypadku i pomiar początku odtwarzania na głośniku. Chcę sprawdzić obie ścieżki, lokalne polecenia oraz rozmowę przez agenta, żeby ocenić czas rzeczywiście odczuwany przez użytkownika.